Showing posts with label Academic. Show all posts

November 16, 2011

[乱读书] 数据挖掘导论的导论

Book:Pang-Ning Tan, Michael Steinbach, Vipin Kumar. 数据挖掘导论(Introduction to Data Mining). 机械工业出版社,2010年9月第1版.


这种训练程序一跑就是2个小时的时候最适合乱读书了。最近买了本「数据挖掘导论」和一本「模式识别」,混着读。读「数据挖掘导论」是因为不知道那是什么,读「模式识别」是因为做了很久这方面的东西最近感觉有些混沌想要重读基础知识。所以两边的「乱读书」也会混着更新,懒的看书的就看我瞎侃好了。

数据挖掘是最近挺热的一个方向,业内做的比较好的典型有Google的广告推送、Amazon的推荐服务等等等,都是和数据挖掘相关的。有一个流传甚广的描述DM重要性的案例模板,或者是“可乐和尿不湿摆在一起为什么能提高销量”的故事,或者是“口香糖和电池”的版本,大体的意思都是“数据挖掘可以帮助零售企业,自动地从其大规模的零售数据中,发现一些有用的信息”。这也是本书中对「数据挖掘」所下的定义,关键词是“自动”、“大规模”和“有用”。

数据中的知识发现过程包括:数据→预处理→数据挖掘→后处理→有效信息。预处理包括特征选择、降维、归一化等等,后处理则是为了保证信息的有效性,包括可视化、模式解释和过滤等。数据挖掘在其中最大的作用是自动总结和筛选知识(我认为)。这是一个交叉性和应用性很强的领域,以数据库、分布式技术为基础,涉及统计学、人工智能、机器学习和模式识别等多领域。

其主要难点在于:

可扩展性Scalability。指其处理大规模数据的能力,不单是时间复杂度上的高效,还有对存储空间上的要求,比如海量数据往往意味着无法将其一次性读入主存中。并行或分布式算法往往具有较高的可扩展性;
高维度High Dimensionality。通常会有成百或者上千的属性来修饰数据,可能是时域上的,也可能是空间域上的,这意味着我们需要应付高维向量,这对于某些对维度敏感的传统算法是灾难性的(这点和CV领域很像);
非均匀的复杂的数据Heterogeneous and Complex Data。由于DM的应用领域很广泛,但不同领域的数据的属性是不同的;属性中可能同时混杂着不同类型(连续的、离散的),比如同时包含文本、超链接和图片的网页。这对DM前的数学建模是个挑战;
数据归属和分布式Data Ownership and Distribution。有时,数据并不存储在一个地方;有时,数据并不属于单一的组织。因此,我们需要分布式DM技术。这里的难点主要在三个方面:如何降低分布式系统的通信成本;如何有效地合并多方的DM结果;以及如何处理数据安全的问题;
非传统式的统计分析Non-traditional Analysis。传统统计方法通常是一个假设和验证的过程,需要手工地收集数据、设计实验来验证假说。但当面临大规模数据应用时,这种劳动密集型的实验方法是不可取的。DM是一个自动提出假说并自动收集数据、自动验证的过程,不再有精巧设计的实验,数据更趋于偶然性。

数据挖掘的主要任务可以分为预测Predictive和描述Descriptive两大类。预测类任务指通过数据的一些属性估计其他属性;描述类任务指从数据中获取其隐藏的模式(趋势、相关性、聚类、异常性等等)。

预测建模Predictive Modeling。主要用于解决分类Classification和回归Regression两类问题(这点上与机器学习对预测的定义一致);
关联性分析Association Analysis。指从数据中发掘强烈存在的特征间的关系,这种关系通常通过隐藏的规则或者特征的子集来表示。我们开头提到的“可乐和纸尿布”就属于这类任务;
聚类分析Cluster Analysis。指从数据中发掘拥有相似外观的群体,使得类内距离最小,类间距离最大。比如,寻找商品的相似购买者,或者通过关键词对文档主题的聚类;
异常检测Anomaly Detection。指从数据中检测行为异常者,主要的目标是准确地发现异常行为,并且避免误判。这个应用十分有用,比如通过购买记录检测信用卡的异常消费行为——不符合持卡人的消费习惯或年龄等。

初步感觉这本书会讲到很多和机器学习、模式识别重复的内容,似乎可以理解为统计模型在大规模数据及具体环境下的应用问题,是个讲究实际的领域。

August 9, 2011

[基础算法] Random Forests

Random Forest(s),随机森林,又叫Random Trees[2][3],是一种由多棵决策树组合而成的联合预测模型,天然可以作为快速且有效的多类分类模型。如下图所示,RF中的每一棵决策树由众多split和node组成:split通过输入的test取值指引输出的走向(左或右);node为叶节点,决定单棵决策树的最终输出,在分类问题中为类属的概率分布或最大概率类属,在回归问题中为函数取值。整个RT的输出由众多决策树共同决定,argmax或者avg。
8-9-2011 2-41-59 PM

Node Test
node test通常很简单,但很多简单的拧在一起就变得无比强大,联合预测模型就是这样的东西。node test是因应用而异的。比如[1]的应用是基于深度图的人体部位识别,使用的node test是基于像素x的深度比较测试:
8-9-2011 2-53-40 PM
8-9-2011 2-54-54 PM
简单的说,就是比较像素x在u和v位移上的像素点的深度差是否大于某一阈值。u和v位移除以x深度值是为了让深度差与x本身的深度无关,与人体离相机的距离无关。这种node test乍一看是没有意义的,事实上也是没多少意义的,单个test的分类结果可能也只是比随机分类好那么一丁点。但就像Haar特征这种极弱的特征一样,起作用的关键在于后续的Boosting或Bagging——有效的联合可以联合的力量。

Training
RF属于Bagging类模型,因此大体训练过程和Bagging类似,关键在于样本的随机选取避免模型的overfitting问题。RF中的每棵决策树是分开训练的,彼此之间并无关联。对于每棵决策树,训练之前形成一个样本子集,在这个子集中有些样本可能出现多次,而另一些可能一次都没出现。接下去,就是循序决策树训练算法的,针对这个样本子集的单棵决策树训练。
单棵决策树的生成大致遵循以下过程:
1)随机生成样本子集;
2)分裂当前节点为左右节点,比较所有可选分裂,选取最优者;
3)重复2)直至达到最大节点深度,或当前节点分类精度达到要求。
这一过程是贪婪的。
当然对于不同的应用场合,训练过程中,会有细节上的差别,比如样本子集的生成过程、以及最优分割的定义。
在[1]中,决策树的真实样本其实是图片中的像素x,变量值则是上文提到的node test。但是,对于一张固定大小的图片而言可取的像素x是可数大量的,可取的位移(u,v)和深度差阈值几乎是不可数无限的。因此,[1]在训练单棵决策树前,要做的样本子集随机其实涉及到像素x集合的随机生成、位移(u,v)和深度差阈值组合的随机生成,最后还有训练深度图集合本身的随机生成。
最优分裂通常定义为使信息增量最大的分类,如[1]中的定义:
8-9-2011 3-34-37 PM
H指熵,通过分裂子集的部位标签分布计算。


Reference:
[1] J. Shotton, A. Fitzgibbon, M. Cook, T. Sharp, M. Finocchio, R. Moore, A. Kipman, and A. Blake. Real-Time Human Pose Recognition in Parts from a Single Depth Image. In CVPR 2011.
[2] L. Breiman. Random forests. Mach. Learning, 45(1):5–32, 2001.
[3] T. Hastie, R. Tibshirani, J. H. Friedman. The Elements of Statistical Learning. ISBN-13 978-0387952840, 2003, Springer.
[4] V. Lepetit, P. Lagger, and P. Fua. Randomized trees for real-time keypoint recognition. In Proc. CVPR, pages 2:775–781, 2005.

August 4, 2011

[源码笔记] OpenCV 2.3 :: Random Trees(二)

源码细节:

● 训练函数

bool CvRTrees::train( const CvMat* _train_data, int _tflag,
                        const CvMat* _responses, const CvMat* _var_idx,
                        const CvMat* _sample_idx, const CvMat* _var_type,
                        const CvMat* _missing_mask, CvRTParams params )

Step1:清理现场,调用clear()函数,删除和释放所有决策树,清除训练数据等;

Step2:构造适用于单棵决策树训练的参数包CvDTreeParams,主要就是对CvRTParams中一些参数的拷贝;

Step3:构建训练数据CvDTreeTrainData,主要涉及CvDTreeTrainData::set_data()函数。CvDTreeTrainData包含CvDTreeParams格式的参数包、被所有树共享的训练数据(优化结构使最优分裂更迅速)以及response类型和类数目等常用数据,还包括最终构造出来的树节点缓存等。

Step4:检查CvRTParams::nactive_vars使其不大于最大启用变量数;若nactive_vars传参为0,则默认赋值为最大启用变量数的平方根;若小于0,则报错退出;

Step5:创建并初始化一个变量活跃Mask(1×变量总数),初始化过程设置前nactive_vars个变量mask为1(活跃),其余为0(非活跃);

Step6:调用CvRTrees::grow_forest()开始生成森林。

● 生成森林

bool CvRTrees::grow_forest( const CvTermCriteria term_crit )

Step1:如果需要以准确率为终止条件或者需要计算变量的重要值(is_oob_or_vimportance = true),则需要创建并初始化以下数据:
oob_sample_votes  用于分类问题,样本数量×类数量,存储每个样本的测试分类;
oob_responses  用于回归问题,2×样本数量,这是一个不直接使用的数据,旨在为以下两个数据开辟空间;
oob_predictions_sum  用于回归问题,1×样本数量,存储每个样本的预测值之和;
oob_num_of_predictions  用于回归问题,1×样本数量,存储每个样本被预测的次数;
oob_samples_perm_ptr  用于存储乱序样本,样本数量×类数量;
samples_ptr / missing_ptr / true_resp_ptr  从训练数据中拷贝的样本数组、缺失Mask和真实response数组;
maximal_response  response的最大绝对值。

Step2:初始化以下数据:
trees  CvForestTree格式的单棵树集合,共max_ntrees棵,max_ntrees由CvDTreeParams定义;
sample_idx_mask_for_tree  存储每个样本是否参与当前树的构建,1×样本数量;
sample_idx_for_tree  存储在构建当前树时参与的样本序号,1×样本数量;

Step3:随机生成参与当前树构建的样本集(sample_idx_for_tree定义),调用CvForestTree::train()函数生成当前树,加入树集合中。CvForestTree::train()先调用CvDTreeTrainData::subsample_data()函数整理样本集,再通过调用CvForestTree::try_split_node()完成树的生成,try_split_node是一个递归函数,在分割当前节点后,会调用分割左右节点的try_split_node函数,直到准确率达到标准或者节点样本数过少;

Step4:如果需要以准确率为终止条件或者需要计算变量的重要值(is_oob_or_vimportance = true),则:
使用未参与当前树构建的样本,测试当前树的预测准确率;
若需计算变量的重要值,对于每一种变量,对每一个非参与样本,替换其该位置的变量值为另一随机样本的该变量值,再进行预测,其正确率的统计值与上一步当前树的预测准确率的差,将会累计到该变量的重要值中;

Step5:重复Step3 - 4,直到终止条件;

Step6:若需计算变量的重要值,归一化变量重要性到[0, 1]。

●训练单棵树

void CvDTree::try_split_node( CvDTreeNode* node )

Step1:调用CvDtree::calc_node_value()函数:对于分类问题,计算当前节点样本中最大样本数量的类别,最为该节点的类别,同时计算更新交叉验证错误率(命名带有cv_的数据);对于回归问题,也是类似的计算当前节点样本值的均值作为该节点的值,也计算更新交叉验证错误率;

Step2:作终止条件判断:样本数量是否过少;深度是否大于最大指定深度;对于分类问题,该节点是否只有一种类别;对于回归问题,交叉验证错误率是否已达到指定精度要求。若是,则停止分裂;

Step3:若可分裂,调用CvForestTree::find_best_split()函数寻找最优分裂,首先随机当前节点的活跃变量,再使用ForestTreeBestSplitFinder完成:ForestTreeBestSplitFinder对分类或回归问题、变量是否可数,分别处理。对于每个可用变量调用相应的find函数,获得针对某一变量的最佳分裂,再在这所有最佳分裂中依照quality值寻找最最优。find函数只关描述分类问题(回归其实差不多):

CvForestTree::find_split_ord_class():可数变量,在搜寻开始前,最主要的工作是建立一个按变量值升序的样本index序列,搜寻按照这个序列进行。最优分裂的依据是
8-3-2011 3-02-54 PM
也就是左右分裂所有类别中样本数量的平方  / 左右分裂的样本总数,再相加(= =还是公式看的懂些吧。。)
比如说,排序后的 A A B A B B C B C C 这样的序列,比较这样两种分裂方法:
          A A B A B B | C B C C 和 A A B A B B C B | C C
          第一种的quality是 (32 + 32 + 02) / 6 + (02 + 12 + 32) / 4 = 5.5
          第二种的quality是 (32 + 42 + 12) / 8 + (02 + 02 + 22) / 2 = 5.25
第一种更优秀些。感性地看,第一种的左分裂只有AB,右分裂只有BC,那么可能再来一次分裂就能完全分辨;而第二种虽然右分裂只有C,但是左分裂一团糟,其实完全没做什么事情。
最优搜寻过程中会跳过一些相差很小的以及不活跃的变量值,主要是为了避免在连续变量取值段出现分裂,这在真实预测中会降低树的鲁棒性。

CvForestTree::find_split_cat_class():不可数变量,分裂quality的计算与可数情况相似,不同的是分类的标准,不再是阈值对数值的左右划分,而是对变量取值的子集划分,比如将a b c d e五种可取变量值分为{a} + {b, c, d, e}、{a, b} + {c, d, e}等多种形式比较quality。统计的是左右分裂每个类别取该分裂子集中的变量值的样本数量的平方 / 左右分裂的样本总数,再相加。同样,搜寻会跳过样本数量很少的以及不活跃的分类取值。

Step4:若不存在最优分裂或者无法分裂,则释放相关数据后返回;否则,处理代理分裂、分割左右分裂数据、调用左右后续分裂。


References:
[1] OpenCV 2.3 Online Documentation: http://opencv.itseez.com/modules/ml/doc/random_trees.html
[2] Random Forests, Leo Breiman and Adele Cutler: http://www.stat.berkeley.edu/users/breiman/RandomForests/cc_home.htm
[3] T. Hastie, R. Tibshirani, J. H. Friedman. The Elements of Statistical Learning. ISBN-13 978-0387952840, 2003, Springer.

August 1, 2011

[源码笔记] OpenCV 2.3 :: Random Trees(一)

OpenCV2.3中Random Trees(R.T.)的继承结构:
7-22-2011 10-25-55 AM

API:

CvRTParams 定义R.T.训练用参数,CvDTreeParams的扩展子类,但并不用到CvDTreeParams(单一决策树)所需的所有参数。比如说,R.T.通常不需要剪枝,因此剪枝参数就不被用到。
max_depth
  单棵树所可能达到的最大深度
min_sample_count  树节点持续分裂的最小样本数量,也就是说,小于这个数节点就不持续分裂,变成叶子了
regression_accuracy  回归树的终止条件,如果所有节点的精度都达到要求就停止
use_surrogates  是否使用代理分裂。通常都是false,在有缺损数据或计算变量重要性的场合为true,比如,变量是色彩,而图片中有一部分区域因为光照是全黑的
max_categories  将所有可能取值聚类到有限类,以保证计算速度。树会以次优分裂(suboptimal split)的形式生长。只对2种取值以上的树有意义
priors  优先级设置,设定某些你尤其关心的类或值,使训练过程更关注它们的分类或回归精度。通常不设置
calc_var_importance  设置是否需要获取变量的重要值,一般设置true
nactive_vars  树的每个节点随机选择变量的数量,根据这些变量寻找最佳分裂。如果设置0值,则自动取变量总和的平方根
max_num_of_trees_in_the_forest  R.T.中可能存在的树的最大数量
forest_accuracy  准确率(作为终止条件)
termcrit_type  终止条件设置
  -- CV_TERMCRIT_ITER  以树的数目为终止条件,max_num_of_trees_in_the_forest生效
  -- CV_TERMCRIT_EPS  以准确率为终止条件,forest_accuracy生效
  -- CV_TERMCRIT_ITER | CV_TERMCRIT_EPS  两者同时作为终止条件
CvRTrees::train 训练R.T.
return bool  训练是否成功
train_data  训练数据:样本(一个样本由固定数量的多个变量定义),以Mat的形式存储,以列或行排列,必须是CV_32FC1格式
tflag  trainData的排列结构
  -- CV_ROW_SAMPLE  行排列
  -- CV_COL_SAMPLE  列排列
responses  训练数据:样本的值(输出),以一维Mat的形式存储,对应trainData,必须是CV_32FC1或CV_32SC1格式。对于分类问题,responses是类标签;对于回归问题,responses是需要逼近的函数取值
var_idx  定义感兴趣的变量,变量中的某些,传null表示全部
sample_idx  定义感兴趣的样本,样本中的某些,传null表示全部
var_type  定义responses的类型
  -- CV_VAR_CATEGORICAL 分类标签
  -- CV_VAR_ORDERED(CV_VAR_NUMERICAL)数值,用于回归问题
missing_mask  定义缺失数据,和train_data一样大的8位Mat
params  CvRTParams定义的训练参数
CvRTrees::train 训练R.T.(简短版的train函数)
return bool  训练是否成功
data  训练数据:CvMLData格式,可从外部.csv格式的文件读入,内部以Mat形式存储,也是类似的value / responses / missing mask。
params CvRTParams定义的训练参数
CvRTrees:predict 对一组输入样本进行预测(分类或回归)
return double  预测结果
sample  输入样本,格式同CvRTrees::train的train_data
missing_mask  定义缺失数据

Example:

  1. #include <cv.h>
  2. #include <stdio.h>
  3. #include <highgui.h>
  4. #include <ml.h>
  5. #include <map>
  6.  
  7. void print_result(float train_err, float test_err,
  8.                   const CvMat* _var_imp)
  9. {
  10.     printf( "train error    %f\n", train_err );
  11.     printf( "test error    %f\n\n", test_err );
  12.  
  13.     if (_var_imp)
  14.     {
  15.         cv::Mat var_imp(_var_imp), sorted_idx;
  16.         cv::sortIdx(var_imp, sorted_idx, CV_SORT_EVERY_ROW +
  17.             CV_SORT_DESCENDING);
  18.  
  19.         printf( "variable importance:\n" );
  20.         int i, n = (int)var_imp.total();
  21.         int type = var_imp.type();
  22.         CV_Assert(type == CV_32F || type == CV_64F);
  23.  
  24.         for( i = 0; i < n; i++)
  25.         {
  26.             int k = sorted_idx.at<int>(i);
  27.             printf( "%d\t%f\n", k, type == CV_32F ?
  28.                 var_imp.at<float>(k) :
  29.                 var_imp.at<double>(k));
  30.         }
  31.     }
  32.     printf("\n");
  33. }
  34.  
  35. int main()
  36. {
  37.     const char* filename = "data.xml";
  38.     int response_idx = 0;
  39.  
  40.     CvMLData data;
  41.     data.read_csv( filename ); // read data
  42.     data.set_response_idx( response_idx ); // set response index
  43.     data.change_var_type( response_idx,
  44.         CV_VAR_CATEGORICAL ); // set response type
  45.     // split train and test data
  46.     CvTrainTestSplit spl( 0.5f );
  47.     data.set_train_test_split( &spl );
  48.     data.set_miss_ch("?"); // set missing value
  49.  
  50.     CvRTrees rtrees;
  51.     rtrees.train( &data, CvRTParams( 10, 2, 0, false,
  52.         16, 0, true, 0, 100, 0, CV_TERMCRIT_ITER ));
  53.     print_result( rtrees.calc_error( &data, CV_TRAIN_ERROR),
  54.         rtrees.calc_error( &data, CV_TEST_ERROR ),
  55.         rtrees.get_var_importance() );
  56.  
  57.     return 0;
  58. }


References:
[1] OpenCV 2.3 Online Documentation: http://opencv.itseez.com/modules/ml/doc/random_trees.html
[2] Random Forests, Leo Breiman and Adele Cutler: http://www.stat.berkeley.edu/users/breiman/RandomForests/cc_home.htm
[3] T. Hastie, R. Tibshirani, J. H. Friedman. The Elements of Statistical Learning. ISBN-13 978-0387952840, 2003, Springer.

July 21, 2011

[无责任乱翻] M.L.是咩啊

[无责任乱翻] Machine Learning, Wald I, July 2002

M.L.是咩啊?(这个缩写邪恶吧)

神经网络(Neural Net,NN)大约发明于1985年,它将两个不同的团体带到了一起:
脑科学家——用NN为人脑的各种功能建模
计算机学者——研究语音识别(Speech Recognition)、字迹识别(Written Character Recognition)以及其他一些困难的预测问题(Prediction Problem)

之后:
一群机器人狂热分子也加入了这个团体,他们感兴趣的有:
监督式训练(Supervised Training)、自学习机器人(Self-learning Robots)

还有:
其余杂七杂八的团体,人工智能(Artificial Intelligence)、PCA学习(PAC Learning)

然后,有个毛会——NIPS(Neural Information Processing Systems)诞生了。刚开始,NIPS是各种NN应用目的萌发的温床。NN在预测问题上工作得很好,尽管存在它有一坨局部极值,尽管它总是面临过拟合(Overfitting)的危险。一些牛掰的人开始裁剪NN巨大的结构,来解决一些特殊的问题,比如旋转平移无关的字母识别,等等。

再后来,NIPS发展啊发展啊,变得越来越复杂,包含很多兴趣完全不同的团体,比如信号处理(Signal Processing)、机器视觉(Computer Vision),等等等等。

到了2000后,NIPS上发表的论文五花八门,也迎来了越来越多的外籍与会者,他们中大多数是计算机学者,还有一些工程师、物理学家、数学家。都很年轻,30来岁,充满活力。他们的工作都是严格意义上算法级别的。也是这个时候,M.L.在统计学方向,迎来了荒野上的第一阵歌声。预测问题成为研究热点,包括回归(Regression)和分类(Classification)。

2001年,重大的突破,两类牛掰算法的诞生:
-- 支持向量机(Support Vector Machines,Vapnik)
-- 联合预测模型(Combining Predictors):Bagging(Breiman)、Boosting(Freund and Schapire)
Bagging和Boosting都是将一坨小预测模型联合在一起,组成强模型(“我来组成头部!”“我来组成身体!”“我来组成腿~~!”“…”)。
不同的是它们的训练过程。
Bagging,又叫Bootsrap Aggregating,将样本集随机采样形成若干个子样本集,其中一些样本可能出现多次,而另一些则可能一次都不出现。Bagging针对每一个子样本集训练一个弱模型,再把它们联合起来形成强模型,联合的方法通常对于回归问题是Average,对于分类问题则是Voting。典型的算法,比如Random Forests。
Boosting,可能稍微有名一点,则是在迭代训练过程中,逐渐改变各个样本的权重,来生产新的弱模型,并加入强模型。在训练过程中,被成功识别或离回归函数近的样本权重不断下降,而错误识别或离回归函数远的样本则权重不断增加,这类似于高考前做模拟题时老师总是叮嘱好好看做错的题目,一样的道理。典型的算法,比如有名的AdaBoost。
(SVM我跳过,不感兴趣,简单地说是个将已经很复杂的样本空间折腾到一乱七八糟的超空间然后画一超平面的算法)

再后来的事,就是现在的事了,统计学习统治世界什么的。不过,我一向认为统计学习并不是机器学习——尤其是人工智能——的终点,因为人类似乎并不是这么思考的。

May 12, 2011

[论文笔记] Real-Time Human Pose Recognition in Parts from Single Depth Images

Paper:J. Shotton, A. Fitzgibbon, M. Cook, T. Sharp, M. Finocchio, R. Moore, A. Kipman, and A. Blake. Real-Time Human Pose Recognition in Parts from a Single Depth Image. In CVPR 2011. http://research.microsoft.com/apps/pubs/default.aspx?id=145347


问题描述:文章提出了一种从单张深度图中提取3D骨架节点的方法。这种方法并不使用动作的时序信息,但是快速有效,识别帧率在200fps左右(GPU加速后),精度不逊于现有算法。这也是Kinect动作识别的核心算法。
文章最主要的贡献在于:将Pose estimation作为Object recognition看待,提出了一种新颖的识别方法——将Body part segmentation问题作为基于像素的分类问题来处理,这样就不需要对不同节点组合进行搜索,但同时单一部位很可能在局部剧烈地变化。算法的计算复杂度低,精度高。文章的实验部分还论证了以下观点:1)作为训练用的深度数据,合成数据可以很好地代替真实数据;2)获得高精度的重要一步是扩大并丰富训练数据;3)文章中提出的基于部位的识别方法比模糊的精确最近相邻节点更具有通用性。
2011-5-12 20-04-00

数据:
数据来源是几乎所有机器学习相关算法的头痛问题。对于动作识别,首先,出于对人物的着装、发型、材质等因素的多样性考虑,使用图形技术合成的训练图片在色彩和材质等方面均有很大的变数,使用深度图片虽然能避免一部分变数,但由着装和发型等带来的形状差异却无法规避;其次,驱动人物的动作数据本身均不可避免地来自Motion capture,这使得获取大量动作的工作量变得很大,虽然有一些技术致力于模拟人物动作,但至今尚不能解决人物主动运动的问题。
文章的真实深度图片来自于Kinect深度相机,由Primesense提供技术支持,是一种基于不可见近红外光的结构光深度恢复技术。这种深度摄像头可以在低光强度的环境下工作,提供一种标定尺度的深度估计,对色彩和纹理不敏感,可以天然地应对轮廓中的遮挡,最重要的是使得前背景分离问题变得简单,并且合成深度训练图也是相对直接简单的。文章的训练深度图片使用Mocap数据绑定多种不同的模型渲染生成。为了保证数据的多样性,在从大规模采集的数据中随机时,定义姿势之间的最小距离;对应人体部位识别的方法,训练数据的纹理也根据既定的分块着色,如下图所示。最终生成约100k frame训练数据。
2011-5-12 18-52-24

部位标识 / 部位识别 / 骨架生成:
部位标识的精度是可以根据需求自由定义的。文章中使用31个部分的部位标识:头4部分、脖子、2个肩膀等。
部位识别基于像素,即对每一个像素识别其所属部位。特征选择和识别算法引用了Lepetit等05年的工作(点我):特征选用简单的深度比较特征,识别算法使用多类随机决策树,树节点test为特征值是否大于某一阈值。训练过程微软采用了10million张图片,每张均匀随机2000个样本像素,训练了3棵20-depth的树,训练过程采用分布式实现,在1000核cluster上运行了约一天。(这个time consumption +_+)
骨架生成是基于像素部位分类和像素深度的聚类,使用加权高斯核的Mean-shift算法。这样得到的骨架节点在人体表面,之后需要有一个z值的向后偏移,才能得到正确的3D骨架节点。这个偏移值可以通过各个部位的分别学习获得。

效果:
简单的说,算法效率实时,效果不错。至少这是做了这么多年,第一次实时又有效的几乎万能动作识别算法。
像素级部位标识的精度在50-60%之间,整体骨架的精度大多部位在90%以上,wrist和hand的识别率较低,在80%以上。算法表现出样本越多,精度越高的现象(废话),且在大样本前提下over-fit的现象也能被避免。


这个文章的工作在本年会完全follow一次,末了再写个详细的算法评价。

May 10, 2011

[论文笔记] Randomized Trees for Real-Time Keypoint Recognition

Paper:V. Lepetit, P. Lagger, and P. Fua. Randomized Trees for Real-Time Keypoint Recognition. In Proceedings of the Conference on Computer Vision and Pattern Recognition, San Diego, CA, June 2005.


问题描述:文章是作者在前作基础上(04年ICCV)的完善之作,研究广泛意义上的特征点匹配问题,应用于相机定标、目标检测等各种领域。特征点匹配算法发展到现在,虽然对形状、视点、光照等变化及遮挡等逐渐变得鲁棒,但是没有算法引入过目标的三维信息和可能可以获得的训练图片等,匹配效果还有较大的提升空间。文章提出的算法引入了这些额外的信息,离线合成目标稳定特征点的各个视角,实时通过多类随机决策树将检测到的特征点分类(识别对应视角),最终使用RANSAC-method估计目标的3D姿态,达到匹配的目的。算法有效、实时、鲁棒。

训练数据的获取
对于立体目标,至少需要2张训练图片;对于平面目标,至少1张。对于目标的每一个特征点,生成其在各个视点下以其为中心的patch合集,如下图所示。假设目标是平面的,简单的仿射变换即可,定义缩放、选择、扭曲等参数,通过随机参数的方式生成样例;但对于立体的目标,至少需要2张不同视角的图片,用于重建目标的三维模型,再通过渲染技术生成样例(或者像google街景一样使用基于图像的渲染技术)。注:只适用于非凹体。所有的样本在训练之前还会进行高斯化、2D朝向估计与对齐的预处理,作为归一化的手段,使得分类更为容易。
2011-5-10 14-11-42

特征点的选择和识别
在众多样本及实时数据中,由于目标的扭曲、视点遮挡等原因,特征点并不一直保持统一。出于鲁棒性的考虑,需要选择其中最稳定的特征点,即在大多数视点下都能被检测到的特征点。另外,合成的样本图片被加入白噪声(接近真实的相机拍摄结果)和噪声背景,使得训练结果天然地对图像噪声鲁棒。
特征点的识别,文章中使用的多类随机决策树(或随机决策森林),相对于前作中的KNN算法更为高效,而且天然地适用于多类分类的问题。决策树节点的test使用简单的像素亮度对比。在实时识别中,图像的每个特征点patch的分类,由从每棵决策树获得的分类置信分布的平均值决定(取其最大者)。当置信值小于某一阈值时,认为该特征点不与任一目标特征点匹配。

结果
文章称,训练20棵10-depth的决策树森林,在普通PC上需要约15min,能够达到至少80%的识别率。实时的识别速度能够达到camera frame的速度,也就是约30fps。微软在kinect的核心算法中也借鉴了这篇文章的思路,并使用GPU加速识别过程,最后加上基于mean-shift的骨架生成,也是实时的速度,因此文章所称的实时效率是可信的。在效果上,文章对比了SIFT算法,称在高distort的情况下,SIFT只能检测到很少的匹配特征点,而此算法依旧;但在处理Scale情况时没有SIFT鲁棒,但这与算法框架本身无关,只是因为在选择特征点时没有使用多scale的特征。


文章的亮点在于其算法框架,即将特征点匹配问题转化为特征点的分类问题。其次,通过渲染技术生成特征点在各个视点下的Patch,也很有新意。是一种逆问题与正问题的结合思路。而且,此算法的效率也十分美。不过,相对于其他特征点匹配算法,需要训练,即是它的创新,也是它的弱点。毕竟,想要获得好的结果,一两张训练数据总是不太让人信任的;况且,需要训练的算法,其通用性往往受到制约,其易用性也自然比不上拈来即可用的算法。但不可否认,这是一个很有意思的算法。

April 20, 2011

[基础算法] Graph Cut and Its Application in Computer Vision

网络流算法最初用于解决流网络的优化问题,比如水管网络、通信传输和城市的车流等。Graph cut作为其中一类最常见的算法,用于求解流网络的最小割,即寻找一个总容量最小的边集合,去掉这个集合中的所有边将阻断这个网络。图像和视频也能被视作网络(或者MRF),以像素作为节点,具体应用定义相邻像素间边的能量值(容量)。因此从九十年代末开始,Graph cut渐渐被引入计算机视觉、图像处理和机器学习领域,用于优化分类、分割和合成等问题。

The Max-Flow and Min-Cost Problem:
定义图(或者流网络)G = (V, E),可以为有向图或无向图。图中所有的边 e(u, v) ∈ E 附有一个非负的容量 c(u, v) ≥ 0,即该边所能承受的最大流量。图中通常定义两个特殊的节点,源点 s 和终点 t;存在拥有多个端点的图,对其的Max-flow求解为NP问题,需要转化为双端点问题求解次优解。定义满足以下条件的 f : VXV → R 为图 G 上的流:
   ●  Capacity Constrain,对于所有 u, v ∈ V,f(u, v) ≤ c(u, v)
   ●  Skew Symmetry,对于所有 u, v ∈ V,f(u, v) = ﹣f(u, v)
   ●  Flow Conservation,对于所有 u ∈ V﹣{s, t} 和 v ∈ V,∑ f(u, v) = 0
从 s 出发的所有流量的总和就是整个图的总流量。如下图所示,图的当前总流量为19,没有达到最大值。
 
Cut(割)将整个图的所有节点分为两个不相交的集合 S 和 T,比如s ∈ S,t ∈ T。割的容量定义为:
     c(S, T) = ∑x∈S ∑y∈T c(x, y)。
Min-cut(最小割)就是图的所有割中容量最小的一个。算法上要直接找Min-cut是十分困难的,根据最大流最小割定理,即图的最大流量等于图的最小割容量,通常要将问题转化为与之等价的Max-flow问题(理论推导点我)。

Max-Flow and Min-Cost Algorithms:
Max-flow问题的求解有两类经典的算法,增广路径[1] 和Push-relabel [2]。增广路径类算法遵循循序渐进的原则,不断在图上查找从 s 到 t 的可用路径,从0开始慢慢地提升图的总流量至最大;而Push-relabel类算法则从局部出发,总是尽可能地向图中输送更多的流量,在不断重复的Push和Relabel操作中达到节点间的平衡,是水流的一种拟态。Push-relabel类算法具有较高的并行性,适用于GPU加速,大体流程点我。
增广路径类算法有很多衍生,但大多具有以下特性:1)维护残余容量网络;2)通过寻找Augmenting path逼近最大流。Augmenting path具有形式:s, e1, v1, e2, v2, … , ek, t,其中没有重复的节点、没有饱和的前向边和空流量的后向边。对残余网络的定义有很多形式,这里我们定义边的残余容量(Redsidual capacity,RC)当其为前向边时等于 c(i, j) – f(i, j),当其为后向边时等于 f(i, j),如下图所示。
 
Augmenting path的残余容量为其每条边残余容量的最小值,如上图路径的残余容量为1。Ford-Fulkerson算法不断在残余网络中查询Augmenting path,比如使用广度或深度优先搜索,直到再也找不到任何路径。例子点我。Boykov[3] 提出一种双向搜索并重用搜索树的增广路径算法,虽然理论复杂度较高,但在实际应用中却效率较高,因此很多需要Graph cut的应用都采用Boykov提供的源代码。

Applications in Computer Vision:
计算机视觉中很多问题,都可以归结为量化方程的优化问题。比如图像分割的问题,定义每一个像素属于前景或背景的可能性度量,那整个问题就变成了如何让整个可能性量化方程取值最大的问题。当然有时,我们还需要定义平滑项,用于约束相邻像素的属性变化。这就形成了在视觉中最为常见的一类能量优化方程:
      E(f) = Esmooth(f) + Edata(f)
1维图还可用动态规划方法求解,但2维以上由于其几何级的复杂度增长,则大多使用Graph cut。典型的应用有Segmentation、Stereo matching、Image Restoration、Motion estimation等。根据不同的应用有不同的图构、相邻约束和能量函数。Kolmogorov[4] 研究了什么样的能量方程能用Graph cut优化,并提出了三元及以下能量函数自动转换成图的方法。

Multi-label Graph Cut:
根据应用的需要,有时定义的图构是多个label的,也就是有多个灭点,如下图所示。这种图的Min-cut是Multi-way的,求解过程是一个NP问题(Boykov[3]在他的论文中有详细证明)。比如Stereo matching中的disparity、Image Restoration中的intensity等,其本质都是一个Multi-label的优化问题。虽然有些方法可以将其人为地转变为2-label,但这在很大程度上限制了能量函数的定义。
4-20-2011 5-01-57 PM
Boykov[3]提出了两种算法,能够在多项式时间内逼近Muli-label问题的最优解,并给出了详细证明和两种算法的optimality property讨论。这是一篇值得细读的文章。这两种方法都是在寻找Local minima,最终使得图中的任意一个像素改变其label都不能产生更好的解。在每一次迭代中,两种方法分别进行 α-expansion 和 α-β-swap 形式的move 优化。α-expansion move 是指扩展 α-label 区域,使原本其他 label 的点属于 α;α-β-swap move 则只针对 α-label 和 β-label 区域,使其中的一些点的label从 α 变为 β 或相反。每一部迭代都是一次2-label的优化过程,形成以 α 和 非α 为灭点、以及以 α 和 β 为灭点的图,寻找最优cut,重整label,不断逼近最优解。α-expansion 要求平滑项满足三边定理,而 α-β-swap 可用于任意平滑项定义;但 α-expansion 有严格的optimality property bound,总不会产生太坏的结果,因此被较多地使用。

Dynamic Graph Cut:
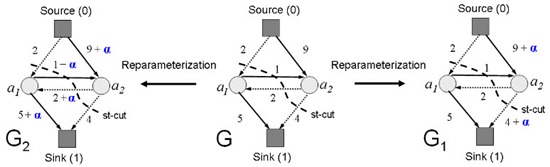
动态图指一个图序列,在时序上前后图直接会保持平滑的过渡,因此,是否可以在前一张图的residual graph基础上修改变化了的像素点的能量以快速地求解?Dynamic graph cut并不寻求最优解,而是次优的快速的解。Kohli[12] 使用重新参数化图(Graph Reparameterization)的方法修改动态变化的数值,并保持Capacity、Flow等基本约束,而后直接得到次优解。这种方法可以容忍少量边的修改和少量任意节点拓扑的重构,但是和其他所有Dynamic graph cut算法一样,以少量、也就是轻微的时序变化为前提。主要应用于视频相关的视觉方法,如Video segmentation。
4-20-2011 5-14-35 PM 


Bibliography:
[1] L. Ford , D. Fulkerson. Flows in Networks. Princeton University Press, 1962.
[2] Andrew V. Goldberg, Robert E. Tarjan. A new approach to the maximum-flow problem. In Journal of the Association for Computing Machinery, 35(4):921–940, October 1988.
[3] Y. Boykov, V. Kolmogorov. An Experimental Comparison of Min-Cut/Max-Flow Algorithms for Energy Minimization in Vision. In IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI), volume 26, page 1124-1137, 2004.
[4] V. Kolmogorov, R. Zabih. What Energy Functions Can Be Minimized via Graph Cuts? In IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI), volume 26, no.2, page 147-159, 2004.
[5] V. Kolmogorov, R. Zabih. Multi-camera Scene Reconstruction via Graph Cuts. In European Conference on Computer Vision (ECCV), May 2002 (best paper).
[6] Y. Boykov, O. Veksler and R. Zabih. Faster approximate energy minimization via graph cuts. In IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI), volume 23, no. 11, page 1-18, 2001.
[7] S. Roy, I. Cox. A maximum-flow formulation of the n-camera stereo correspondence problem. In International Conference on Computer Vision (ICCV), 1998.
[8] V. Vineet, P. J. Narayanan. CUDA Cuts: Fast Graph Cuts on the GPU. In: CVPR Workshop on Visual Computer Vision on GPUs, 2008.
[9] V. Kwatra, A. Schodl, I. Essa, G. Turk and A. Bobick. Graphcut Textures: Image and Video Synthesis Using Graph Cuts. In SIGGRAPH 2003, pp. 277-286.
[10] A. Blum, J. Lafferty, M.R. Rwebangira and R. Reddy. Semi-Supervised Learning Using Randomized Mincuts. In Proceedings of the 21st International Conference on Machine Learning (ICML), Banff, Canada 2004.
[11] S. Z. Li, Markov Random Field Modeling in Computer Vision, Springer Verlag, 1995.
[12] P. Kohli and P. H. S. Torr. Dynamic graph cuts for efficient inference in markov random fields. IEEE Trans. Pattern Anal. Mach. Intell. (PAMI), 29(12):2079–2088, 2007.

March 7, 2011

[基础算法] 一个Ford-Fulkerson算法的例子

Example:
3-7-2011 10-07-02 AM 

Initialized:
2

Augmenting path:s→a→b→t,excess capacity:min(4, 3, 5) = 3
f(G) = 3:
3

Augmenting path:s→a→t,excess capacity:min(1, 5) = 1
f(G) = 4:
4

Augmenting path:s→c→d→t,excess capacity:min(6, 4, 4) = 4
f(G) = 8:
5 

Final result:
6

March 3, 2011

[论文笔记] CUDA Cuts: Fast Graph Cuts on the GPU

Paper:V. Vineet, P. J. Narayanan. CUDA cuts: Fast graph cuts on the GPU. In Proc. CVPR Workshop, 2008.


问题概述:Graph cut是一种十分有用和流行的能量优化算法,在计算机视觉领域普遍应用于前背景分割(Image segmentation)、立体视觉(stereo vision)、抠图(Image matting)等。但在获得不错效果的同时,Max-flow / Min-cost问题求解的时间代价却很大。本文作者称其所知最佳的Graph cut实现求解一张640×480的图至少需100毫秒(平均数据会差得多),无法满足实时应用的需求。但事实上,Max-flow求解中经典的Push-relabel算法在流的计算和维护上只与局部相关,具有潜在的可并行性,适于GPU加速。因此,作者实现了push-relabel算法的GPU版。作者称其算法于一张640×480的图平均每秒可以求解150次Graph cut(Nvidia 8800 GTX),也就是约6.7毫秒速,是传统CPU算法约30-40倍速。作者还提供源码的下载,点我。

Definition & Notation:
对于一个图 G = (V, E) ,其中 V 为节点集合,包括源点 s 和终点 t (也可以定义多个端点,其可以优化为双顶点图)、以及其他诸多中间节点集合 V’ ,E 为连接这些节点的边,每条边附有容量 c(u, v) 代表节点 u 通过这条边流向节点 v 所能承受的最大流量,在具体应用中边的容量通常等价于其能量值。Graph cut的目的在于找到图的Min-cut,Cut将 V’ 分割为两个部分,去掉这些边将使舍得图中的任意一个节点只与 s 或 t 相连通(如下图),而Min-cut是所有cut中边的能量值总和最小的一个。
3-2-2011 2-56-05 PM
算法上要直接找Min-cut是十分困难的,通常要将问题转化为与之等价的Max-flow问题(理论推导点我)。Graph cut具体应用的性能关键在于能量函数的定义,用于计算机视觉中的一种常见能量函数定义如下:
3-2-2011 2-54-11 PM
Dp 定义数据能量,Vp, q 定义平滑度能量,N 定义相邻关系,fp 为像素 p 的标签(属于 s 或 t )。
 

经典Push-relabel算法:
求解Max-flow有两种经典的算法:Ford-Fulkerson和Push-relabel算法。Ford-Fulkerson算法的大意是在图中不断寻找 s 和 t 之间可用路径,记入总流量,并维护一张残余网络(Residual graph),直到再也找不到可用路径为止,此时的总流量就是Max-flow(具体算法点我)。Ford-Fulkerson算法的串行性很大,因为可用路径的查找是全局性的,这是GPU所不擅长的。
 
Push-relabel算法,相对的,具有很强的局部性和可并行性,在每一个子操作中指关心节点及其相邻节点。Push-relabel的基本思路是将尽可能多的流量从 s 推向 t ,但是当 t 已经无法再接受更多的流量时,这些流量将会被反推回 s,最终达到平衡(和Ford-Fulkerson算法一样,再也找不到 s 到 t 的可用路径)。算法过程中的“流”称为Preflow(先流),它并不像Ford-Fulkerson算法过程中的流一样总是持续升高直至Max-flow,而是初始预测一个值,在不断趋近于Max-flow,过程中可能出现回流的现象。Preflow对每一个节点满足 e(u) = in(u) – out(u),且 e(u) ≥ 0。当 e(u) > 0 时,节点 u 溢出(overflowing)。溢出的节点需要将多余的流量Push向其相邻的节点,即Push操作。当一条从 s 到 t 的路径上所有的节点都不溢出时,此路径上的Preflow就变成真正的Flow了。
 
Push-relabel算法和Ford-Fulkerson算法一样都会维护一张残余网络。对于图中的每一个节点 u,若在残余网络中存在 e(u, v),则 h(u) ≤ h(v) + 1。Push操作只能在 h(u) > h(v) ,u 节点溢出且 e(u, v) 残留容量时进行;而当 u 节点溢出,且与之相邻所有残留边节点的 h(v) ≥ h(u) 时,只能进行Label操作,增加节点 u 的高度,即 h(u) += 1。在初始化时,h(s) = n,t 及其他所有节点的高度均为 0;从 s 出发的所有边初始化 f(e) = c(e),其余边 f(e) =0。Push-relabel算法将不断重复Push和Label操作,直至任意操作都无法进行。
(更详细的算法步骤推荐查阅Tutorial,点我)
 
比较形象点,Push-relabel是泛滥的洪水,奔腾向前,堵了就倒流;Ford-Fulkerson则是很温吞的做法,先找个人探路,回来报告能流多少水就开闸放多少。
 

Push-relabel算法的GPU版:
存储和线程结构:
Grid拥有和输入图片一样的维度,并被分为若干个Block,每个Block的维度为 B×B。每个线程对应一个节点(像素),即每个Block对应 B×B 个节点、需要访问 (B+2)×(B+2) 个节点的数据。每个节点包含以下数据:溢出量 e(u),高度 h(u),活跃状态 flag(u) 以及与其相邻节点间的边的容量。活跃状态共3种:Active,e(u) > 0 且 h(u) = h(v) + 1;Passive,e(u) > 0 且 h(u) ≠ h(v) + 1,这种状态在Relabel后可能变成Active;Inactive,没有溢出且没有相邻残留边,
这些数据存储在全局或设备内存中,被所有线程共享。
(GPU架构及Cuda指南参考NVidia相关手册,点我)
 
本文作者通过4个Kernel实现GPU版Push-relabel算法:
1) Push Kernel (node u):

   ■ 将 h(u) 和 e(u) 从全局内存读入到Block共享内存中(使用共享内存是因为一些数据会被相邻线程共享,这种读入方式相对单独的读入更节省时间);
   ■ 同步线程(使用共享内存都需要做这一步,为了保证所有内存都被完全读入了);
   ■ 将 e(u) 按照Push规则推向相邻节点(不大于边的剩余容量,且 h(u) ≥ h(v) );
   ■ 将以上Preflow记入一个特殊的全局数组 F。
之所以记入 F,而不直接写入相邻节点,是因为在并行Push操作时,一个节点的溢出值同时受到多个相邻节点的影响,如果直接写入,可能造成数据的不一致性(Read-after-write data consistency)。因此,作者将原来的Push操作分成了Push和Pull两个Kernel执行(另一种选择是在同一个Kernel中分两部分执行,之间进行一次同步,但是对于Block边缘的节点,这种同步需要等待其他Block的线程,这种Block间的同步并不被所有GPU支持)。
 
2) Pull Kernel (node u):
   ■ 读入 F 中推向 u 的Preflow;
   ■ 累加所有新的Preflow,得到最终的溢出值,记入 e(u) 到全局内存。
  
3) Local Relabel Kernal (node u):
按照经典Push-relabel算法中的Relabel操作,局部地调整节点的高度
   ■ 将 h(u) 和 flag(u) 从全局内存读入到Block共享内存中;
   ■ 同步线程;
   ■ 计算 u 相邻 active / passive 节点的最小高度;
   ■ 该最小高度+1,作为新高度写入 h(u) 到全局内存。
  
4) Global Relabel Kernal:
从终点 t 开始,按照广度优先策略,遍历所有节点,更新其高度至正确的距离(节点的高度总是其与终点距离的下限)。迭代次数 k 被记录与全局内存中。
   ■ 如果 k == 1,所有与 t 相邻且有残留边的节点高度被设为 1;
   ■ 所有未被设置的节点检查其相邻节点,若其相邻节点的高度为 k,则设置该节点高度为 k+1;
   ■ 更新高度值到全局内存。
  
算法总体流程:
a. 计算能量矩阵 → b. Push+Pull Kernel循环 → c. Local Relabel Kernel循环 → d. Global Relabel Kernel循环 → e. 重复b到d至收敛(没有可进行的Push和Relabel操作)


作者还基于GPU实现了Dynamic graph cut,应用于连续细微变化的Graph cut,通过对前一帧的简单修改形成新图,重用其他数据,加速Max-flow的求解。作者的实验数据称GPU实现可以提速70-100倍。不过具体应用具体分析,提速肯定是有的,多少未知,要待我实现过试验过。据说这个印度人提供的代码Bug颇多,虽然不太信,但还是先做了要重新实现的准备。末了,吐个槽,这论文贡献不大,确实只是发Workshop的水平。

November 2, 2010

[论文笔记] Multi-view video based multiple objects segmentation using graph cut and spatiotemporal projections

Paper:Qian Zhang, and King Ngi Ngan. Multi-view video based multiple objects segmentation using graph cut and spatiotemporal projections. In Journal of Visual Communication and Image Representation, Pages 453-461, 2010.


问题描述:这篇文章旨在从多视点视频中分割多个前景物体——Interested Objects(IOs),也是一个综合多通道信息的大算法框架,如下图所示。吸引人的地方在于据作者所述,该算法表现出不俗的精确度、效率和鲁棒性。在架构5个摄像头的实验中,处理640*480分辨率的视频能达到30fps的梦幻速度(不知是否包括预处理和离线操作)。并且,题目中的多前景物体分割也很具吸引力,虽然就实验结果来看,作者并没有考虑前景物体的重叠遮挡情况。

11-2-2010 7-44-07 PM

  • 预处理阶段,做色彩归一化和定标,杂务。
  • 离线阶段,生成一些用于在线阶段的辅助信息:Motion field[1]、Disparity field、Occlusion map、Depth map和Combined occlusion map(详细描述见论文),三维重建相关,可参阅其他文献。
  • 关键视点初始帧操作:
    1) 文章引入一些High-level Feature到Saliency model,如Motion、Depth等。Saliency model(SM)旨在表现人会更关心一幅图像中的那些部分,比如相较于背景更关心前景、更关心运动的物体、更关心图像的中间部分或色彩明艳的部分等。因为人比起机器,更懂得识别场景的语义,所以学人,总是没错的。那么,SM中拥有较高值的块将触发下一步的操作,如下图。
    11-2-2010 9-04-39 PM
    2) 基于Graph cut的多前景物体分割。文章修改了基本的能量方程(事实上,每篇文章都改),在色彩和平滑度的基础上增加了对像素重叠(前景物体边缘是重叠的高发地带,因此联合重叠部分CO比可见部分更有可能是背景)和对比度变化[2]的考虑。另外,对于每一个前景物体,graph cut是分别进行的,在一个Object Rectangle中,用于限制物体的最大区域。and,就文章的实验结果来看,的确比基本的能力方程更有效,如下图。
    11-2-2010 9-05-02 PM
  • 多视点视频前景分割:
    1) 根据上一步得到的关键视点初始帧轮廓,可以通过Visibility Constraint得到其他视点的粗略轮廓;
    2) 类似的,可以通过Motion Projection来获得后继帧的粗略轮廓;
    3) 对于不确定的前景物体边界,再基于像素的activity measure(运动的变化量)应用一次Graph cut来得到精确轮廓线。

首先,文章的实验结果是暂时所见到的诸多segmentation文章中最美好的,虽然只有两个实验用视频,且鉴于以往经验,论文所述的实验结果和conclusion在实际重复其工作时,总会打上些折扣。
其次,私以为,文章存在以下limitation:1)没有考虑前景物体间的遮挡,至少文中并没有说明或证明算法能解决这一问题;2)由于文中算法对除关键视点初始帧以外的其他帧和视点,采取了基于关键视点初始帧轮廓投影的方法,来得到粗略轮廓,也就是说,可能存在由于关键视点初始帧操作崩坏,而带来的集体崩坏现象。那么,我们有理由怀疑文章算法对其他视频的适用性;3)同2)原因,文章算法很可能无法简单地适用于前景物体变化较大的视频,比如突然多了一个人;4)鉴于真实经历,相机定标等杂务,绝不如其在文章中的比例和重要性一样轻巧,并且往往有可能是带来后继问题最多的一部分。

综上所述,虽然文章很美好,拿到实际应用中,总是堪忧的。


[1] L. Itti, P. Baldi, A principled approach to detecting surprising events in video, IEEE Int. Conf. Computer Vision (2005) 631–637.
[2] J. Sun, W.W. Zhang, X.O. Tang, H. Y Shum, Background cut, ECCV (2006).

[论文笔记] Joint 3D-Reconstruction and Background Separation in Multiple Views using Graph Cuts

Paper:B. Goldlcke, M.A. Magnor. Joint 3D-reconstruction and Background Removal Separation in Multiple Views Using Graph Cuts. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition(CVPR ‘03), page 683–688, 2003.


问题描述:这是篇03年的老文章,老耿给的且瞅着作者长得挺不错(点我点我)——其实前面的才是重点,通读了一下。文章的亮点在于同时处理Depth map estimation和Background seperation问题,当然是Multi-view的,而且是精确定标的(不像09年那位拿硬件捣鼓,这篇文章是基于图像像素算算算出来的)。文章认为,如果已知每个像素的深度,那么只有那些深度小于背景的像素,才有可能属于前景;同时,考虑背景因素可以提高三维重建算法的鲁棒性。

帅气一作的强项是三维重建,因此前背景分割则比较像站在他人肩膀上的那位。作者在文中以及Abstract里反复说文中的优化算法衍生于Kolmogorov等人的Multi-Camera Scene Reconstruction via Graph Cuts,他们做的工作是Generalize,所以文章本身的算法描述部分没什么亮点。它的好看之处在于作者对二维点的三维关系和三维点的二位投影的优美定义和量化。

11-2-2010 4-00-23 PM 深度的定义:如果有个面P,所有的摄像头都在P的一边,且朝向P的另一边,那么可以认为在P上的点拥有相同的深度D。这个深度其实是一个离散的、相对的概念。

拓扑结构的定义:Np,指在Pk上与p点相邻的所有,能量函数在这个集合上应当是连续的;Cp,指包括p点的相邻点,用于作为判断图像一致性的标准。

几何结构的定义:<p, l>和<q, l>相交,指p, q来自不同的摄像头,且p是图像上最接近<q, l>在cam j上投影点的点,这种二元关系组成集合打不出来的花体D,其中<p, l>指点p的三维点。(1)
<p, l>遮盖<q, l’>,指满足(1)关系,且Id’<Id(也就是深度小),这种二元关系组成集合打不出的花体J。

然后就可以帅气地定义能量方程:
11-2-2010 4-26-31 PM
其中,第一项指图像一致性,即通俗点讲,如果p,q是同一点,那么其相邻点集合Cq, Cq应该差不多;
第二项指平滑性,即通俗点讲,如果p, q相邻,且它们的颜色也差不多,那么它们的深度也应该差不多,或者在是否是背景这一点上应该是一致的;
第三项指可视性约束,即通俗点讲,如果cam j看到深度为Id的点p,其为<p, l>的投影,<p, l>投影到cam k上最近为q点,那么q点的深度不可能比p点大;
第四项指背景属性,即通俗点讲,如果一个点是背景,那么必须有和背景一样的深度。
具体的量化见论文。

然后,balabala定义完后,就是Graph Cut上演最小能量优化,略。
11-2-2010 4-42-54 PM
11-2-2010 4-43-07 PM
算法结果上来讲,比03年同期的分割算法好些,但是速度嘛。。作者当年用1.8GHz的Pentium III Xeon做个初始化要30秒,320*240的图片处理需要约4次迭代290秒,有点慢的说。。不过人家当年可没有GPU加速的Graph Cut可以用,CPU也够呛,所以放到现在实现起来有多少效率也不知道。不过,鉴于大多源自重建算法的图像分割效率都不怎么样,私以为这算法在效率上是没什么看头的。其余,精度尚可,鲁棒性其实论文说什么都是假的,灵活性倒是高——不用添置新硬件,软件什么的改改还是方便的,总能找到能尝试优化的地方——虽然大多时候是有限且低效的。

以上。

November 1, 2010

[论文笔记] Combining Color, Depth, and Motion for Video Segmentation

Paper:J. Leens, S. Piérard, O. Barnich, M. Van Droogenbroeck, and J.-M. Wagner. Combining color, depth, and motion for video segmentation. Proceedings of the 7th International Conference on Computer Vision Systems: Computer Vision Systems(ICVS ‘09), pages 104–113. Springer, 2009.


问题描述:本文引入TOF摄像头(文中指PMD-camera,TOF-cam的一种),对视频场景做新的解释,并结合传统的彩色分割技术、动态分割技术,做前背景的分割。
传统摄像头提供彩色图像,而PMD-camera提供物体距离、信号强度、信号密度等和物体空间位置相关的场景属性,是一种十分有前景且年轻的技术。不过同时,TOF摄像头也存在一些暂时无法解决的问题,如信号的噪声、受传感器大小限制的分辨率(160*120)、以及估算距离的致信区间、还有定标难等问题。尽管如此,这种新硬件对于交互领域还是非常有趣和有价值的。
11-1-2010 4-25-19 PM 
文中的方法基于像素做前背景分割,避免对场景内容的假设,也不需要任何3D模型的支持。方法结合背景相减技术(Background subtraction tech.)对获得的区域图(Range map)进行处理,获得更鲁棒和准确的分割结果。比如,当人物的颜色和背景的颜色相近时,基于色彩的传统背景相减技术就可能失效,而基于红外信号反馈的PMD-camera就可能返回可用的结果;而,当人物和背景的材质相近,也就是说对红外信号的吸收相近时,传统背景相减技术就能弥补PMD-camera的失效。

作者简单地将两种摄像头上下捆绑,采用简单地仿射变换来对齐图像,回避了TOF-cam定标难的问题。文中采用的背景相减技术引用了09年O. Barnich等人发表的ViBe - a powerful random technique to estimate the background in video sequences 一文,其最显著的特点在于通过一种随机策略来建立基于样本的背景估计和一种全新的策略在相邻的像素间传播信息和状态。
11-1-2010 4-44-01 PM 
文中提出传统技术和PMD-camera联合策略还是比较简单易懂的,如上图所示。图中,T&I 指代Transformation and Interpolation,G.R.指代Geodesic Reconstruction(待考证是什么意思)。究其本质,意在让两种方法互补缺点,如下图所示。据文中所言,能达到实时的速度,较之一些结合立体视觉和颜色技术的算法目前所见最多只有9fps的速度,还是很有吸引力的。
11-1-2010 4-44-23 PM
11-1-2010 4-44-42 PM

October 20, 2010

[论文笔记] Action as Space-Time Shapes

Paper:Moshe Blank, Lena Gorelick, Eli Shechtman, Michal Irani, Ronen Basri, Actions as Space-Time Shapes, IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI ’07), 2007

问题描述:文章将人在视频中的运动看作是身体(torso)和四肢(limbs)做连续运动的轮廓图的集合,因此可以用Space-time volume(STV)来表示人的运动。文章将2D图形的分析方法借鉴到3D,应用泊松方程(Possion Equation)于STV,再提取如Space-time Saliency、Action Dynamics、Shape Structure和Orientation等时空特征。这些特征可以用来检测和识别人体的动作(Action Recognition/Detection)以及动作的聚类。

传统动作识别的方法虽然也能得到不错的结果,但各自都存在一些局限。如,基于光流的方法会受到空洞、表面平滑度、不连续性的影响,基于特征跟踪的方法在存在自遮挡、外观改变和重初始化问题的情况下会面临很多困难,而基于关键帧或关键特征的方法则忽略了动作的时序特征,另外一些基于周期性分析的方法则只限于识别据有周期规律的动作。因此,近期一些动作识别的工作都将眼光放在了同时据有时序和空间特征的STV上。(译自原文)

STV由一系列从视频中提取的2D轮廓连结而成,同时包括了人体的姿势和动态信息。不同于一些相似的基于STV的论文——他们基于STV的表面提取特征,这篇文章的方法应用泊松方程来提取STV的各种特征(包括局部的Space-Time Saliency、Space-Time Orientations特征和全局特征),得到其在应对轮廓边界可能存在的噪声时显得更加鲁棒(得到的结果类似于动作的粗略骨架,对于分析动作很有用)。
   

这种方法的主要优点在于:
1. 不需要帧间对齐(Video alignment);
2. 计算复杂度与STV的采样点个数线性相关,文中言其处理110*70*50 presegmented视频只需要30秒不到的时间(Pentinm 4,3.0 GHz,Matlab,挺快的);
3. 这种算法可以用于处理低精度的视频。

June 8, 2010

[论文笔记] Game Over: Learning by Dying

Paper:Grammenos, Dimitris. Game over: learning by dying. In Proc. of CHI 2008 (Florence, Italy 2008), ACM

问题描述:这是一篇关于游戏开发者如何更容易地理解游戏的可亲性(Game Accessiblity)的文章。作者设计和开发了一款名为“Game Over!”的游戏,帮助开发人员认识游戏可亲性的重要性,并学习关于其的一些原则和指标。这是世界上第一款“Universally inaccessible game”。此外,作者还通过多种渠道的调查,系统地评估了该游戏所起到的效果。

“Game Over!”的灵感来自于1986年发行的视频游戏“Takeshi's Challenge”。它由一个十分讨厌视频游戏的人(北野武,知道他是谁吧)参与企划,在游戏中几乎打破了所有的视频游戏原则,设计了N多无比变态苦役的任务,比如按某个键4小时、唱歌1小时或者打Boss20000次,号称“还没有开始就Game Over的游戏”(但令人称奇的是,如此变态的游戏,居然在日本大卖,当然也因为它是如此变态,它也只在日本卖)。私以为,“Takeshi's Challenge”真正的好玩之处在于它挑起了玩家抵抗变态设计的兴趣,使得他们想尽一切的办法来方便地完成这些变态的任务,而寻找trick本身是十分有趣的。比如,对于“按键4小时”这个任务,拿重物代替手指按住按键就是个很好的trick,玩家所需要做的只是等待、并在4小时后回来观察结果。这款游戏可能是在无意中打开了一种新的解谜游戏的模式。当然,这是题外话。

游戏的可亲性(Game Accessibility)指的是游戏是否能被玩家所参与,私以为与游戏的可用性(Usability)十分相关,但可亲性更加基础些。可亲性理论认为,有一部分玩家无法玩游戏是因为他们自身物理上、感知或者精神上的残疾;但是另外一部分玩家,是由于不好的游戏设计,而无法充分体验其中、甚至根本无法开始它,如:
1)运行时的环境。在一个十分嘈杂的环境中玩游戏,玩家可以被认为是条件性地失聪的。而在一个十分亮的环境中(太阳底下),玩家则是条件性地失明的;
2)玩家使用的硬件和软件环境也会对游戏体验造成影响,比如移动设备的小屏幕、旧型的浏览器或者不同的操作系统,都会对游戏的兼容性提出挑战;
3)最后,由于不同玩家的游戏技巧和喜好不同,也会造成游戏的不可亲性,比如对于一个十分不喜好或者不适应按各种组合键玩格斗游戏的人,好的设计就应该提供其他的可选按键方案。

游戏可亲性是评价一款游戏好坏的一项十分基本和基础的标准,它是衡量隔阂在玩家与游戏之间的障碍的尺度。没有可亲性,谈论可玩性是没有意义的。
因此,有一些组织一直致力于提出和不断完善游戏可亲性的指标(Game Accessibility Guidelines),如GASIG在2004年发布的与此相关的白皮书。但是不幸的是,这种文字指标在实际应用中表现得十分低效和不可用,这主要是因为它们常十分抽象而难以理解,以致于开发人员虽然记住了很多指标,但在遭遇具体问题时却下意识地忽略了它。并且,这些指标有时是相互矛盾的,单条指标在解决了一些问题后偶尔会产生新的问题。
设计人员还可以通过一些反面的例子来学习什么是好的设计,这不是什么新的点子。有一些网站一直在做这样的事情,提供各种各样坏设计的例子,包括真实的产品和软件交互界面等,比如Bad Human Factors Designs,Interface Hall of Shame和Worst of the Web等。相较于抽象的指标,这是一种比较能够让人获得深刻印象的方法。那么,既然最容易让产品设计师吸取教训的方法是浏览失败的产品设计,我们是不是可以认为,让游戏设计师认识可亲性最快捷有效的方法是体验不可亲的游戏呢?是的,这就是此文所设计和开发的世界上最不可亲的游戏“Game Over!”。
普遍认为,游戏开发者大多都是爱玩游戏的,并且,他们中的大多数能够十分清楚地记忆他们所玩过的最好玩的和最不好玩的游戏。当他们在一款失败的游戏中体验到某一种失败的设计后,他们就变得能够认识到与其相似的其他失败设计,并在今后的设计中避免它们。并且,有研究表明,在人的记忆中,一款好玩的游戏可能被另一款更好玩的游戏所覆盖,但是所有曾经遭遇的糟糕的游戏体验都会被清晰地记忆——“Notable failures last for a lifetime“。因此,我们似乎可以预见,“Game Over!”将是一款让人印象深刻的游戏,因为它涵盖了太多无比糟糕的设计。

“Game Over!”作为一款游戏可亲性的学习工具,作者认为应当满足以下要求:
1)Easy:容易。简单。有一个众所周知的目标和游戏机制。这使得游戏玩家可以方便地理解游戏中存在的问题以及造成问题的原因;
2)Break:直接、明显地破坏游戏可亲性原则;
3)One Rule:一次只破坏这些原则中的一条,这使得识别问题所在变得简单;
4)Major:覆盖这些原则中主要的、典型的部分;
5)Advice:在给出这些可亲性原则或概念的同时,针对每一条,给出相应的解决问题的建议;
6)Humor:幽默。这是为了让游戏本身变得有趣;
7)Platform:能够在尽可能多的平台上运行。

基于这些要求,作者挑选了一个射击游戏作为“Game Over!”的蓝本。玩家被设定为一个乘坐飞盘的外星人,抵抗地球人的舰队对宇宙的进攻。这个故事与我们所熟悉的拯救宇宙的故事是恰恰相反的,以强化“Game Over!”与正常游戏的逆关系。游戏共21个关卡,过关条件是失去3条命,即所谓的Learning by Dying(作者认为,好的游戏设计应当总是给出一些提示玩家如何去赢的线索——无论它多么困难——这样即使玩家失败了,他也只会抱怨自己不够厉害,而不会抱怨设计者变态)。在每一关结束,屏幕上会给出与之相关的名言和可亲性原则等,帮助游戏开发者强化记忆。在整个游戏中,玩家可以被杀死,但敌人永远都不会死。也就是说,如果过关条件被设计为杀死敌人,那么这将真的成为一个永远也无法过关的游戏。典型地,有以下关卡:
1)Start Screen:
这是游戏的开始画面,也是一个热身运动。它要求玩家同时按下“Ctrl + Shift + Enter + Home + F3 + F12 + →”键,这是何等变态的要求。哪怕只体验一次,开发者也会记住,减少按键的个数是多么地重要而美好。
2)Level 3 #Hunt and Peck:
在这一关中,游戏的按键控制会被随机地修改为其他,玩家需要去找到它才能避免死亡,但这几乎是不可能的。这一关是在告诉开发者,需要为玩家提供修改游戏控制方式的功能。
3)Level 9 #Chill Out:
这一关,所有的游戏动作会变得十分十分缓慢,类似的在第8关中相当地快。对应的主题则是,为玩家提供控制游戏速度的功能。
4)Level 13 #Low Budget:
所有游戏中的元素会变得十分十分小,类似的在第14关中十分十分大。对应的主题则是,允许玩家控制文字和图像的大小,或提供适应不同屏幕分辨率的解决方案。
5)Level 19 #Chatterbox:
这一关的画面是黑暗不可见的(模拟高光强的情况),但是游戏提供有关敌人和火力所在位置的音频提示,如“Look out! There is a big spaceship that looks really mean on your left”。这显然是十分唠叨的一句提示,它直到最后一个单词才说出玩家所需要的信息。那么显然,这一关所对应的主题是,提供有意义且有效率的语言提示。

游戏制作完成后,作者通过三种方式测试和统计它对游戏开发人员是否有帮助:1)On-line调查;2)面对面的反馈调查;3)公开的网络上关于“Game Over!”的评价的收集,包括一些网站、blog和论坛。在作者提供的数据中,尽管一部分受调查者表示他们事先或多或少地都了解一些游戏可亲性原则,但大多数人的确通过该游戏认识到了更多。并且有趣的是,在48%对游戏可亲性原则了解少于一半的人群中,有38%的人认为该游戏对他们的帮助非常大,33%认为大,29%认为中等,没有人认为没有或只有少量帮助。但也的确收到了一些十分负面的评价,有人认为特地设计一款游戏来学习可亲性是十分没有必要的,抽象的指标就足够了;还有人认为它不够有趣。

我们可以从以下几个方面来看待“Game Over!”游戏的成功与否:
1)受众:
显然,这不是一款适合大众玩家的游戏,作者的目的在于教育游戏开发者。但是由于其包含的可亲性原则的浅显,它可能更适合于初入游戏开发领域的新手。诚如作者调查问卷第一题“How familiar were you with the accessiblity guidelines presented?”的调查结果所示,一些资深开发者对这些原则是十分熟悉的。那么,对于这些人来说,玩这样一款游戏无异于浪费时间。那么,为什么在资深人员手中依然会出现不可亲的设计呢?私以为那是由于开发资金与时间的限制、以及对玩家的蔑视,唯有现实中的教训才能使其反省。在很多游戏开发公司中,通常会摆放一些游戏设备供员工在午休或下班后时间玩游戏。其间不只该公司的游戏,也包括其他竞争者的产品。员工在玩游戏的过程中,通过自身的感受和与队友的讨论,会不断体验到好设计与不好的设计之间的差距。这虽然是一种十分随机和粗放的体验模式,但往往能收到意想不到的效果,比如发现新的原则。
2)可玩性:
由于这并不是一款单纯的游戏,讨论它的可玩性应与其所相应的Guildlines相比较。诚然,它比Guildlines有趣一点,但它也需要开发者耗费更多的时间。并且,有些关卡的内容和其对应的可亲性原则事实上并没有很好地切合,这同样会让开发者感到迷惑。另外,由于它的设计理念和目的,使得它“一点也不好玩”,也就是说,玩家需要时刻以开发者的身份约束自己,才能觉得它相对有趣些。并且,这种最初出于面对好创意的喜悦之情,会随着时间而退去;也就是说,最后,它会变得和Guildlines一样枯燥(事实上,在玩到一半时,我已经感觉到了)。那么,从这个意义上来讲,它与其说是一款学习可亲性原则的游戏,不如说是一款引人注意的、交互繁琐而精良的可亲性Guildlines。
3)评价系统:
在这个方面,作者做得是不错了。他尝试了多种渠道,试图让尽可能多的人试用和反馈“Game Over!”;并撰写了简单直白的调查问卷,仅5个问题,调查使用者玩游戏前、玩游戏后对可亲性原则的认识,以及他们对游戏本身可玩性的看法、是否适合用作教育工具、是否推荐他人等。值得一提的是,作者还进行了面对面的试用调查,并详细记录了试用者的一些言论,这使得评价更加具体并附有个性,再者直接的交流也比调查问卷能更准确地反映试用者的真实感受。

私以为,此文在交互方式的创意上是具有启迪作用的。尤其作为一种针对成人的职业教育工具,它直接将行业产品作为教育的手段,十分直接而富有震撼力。我们总是希望,教育可以跳出文字与图片构成的教材课本,而以一种更为直接、具象和有趣的方式传达知识。那么,此文的观点就是,游戏专业的学生可以以游戏为课本,医学专业的学术可以以人体为课本。再有,就是以夸张的反面教材的堆积,以低廉的方式使人们获得教训。

May 30, 2010

[读书笔记] 游戏测试 Part 2:测试技术

Book:Charles P. Schultz, Robert Bryant, Tim Langdell, Game Testing All in One(周学毛等译, 清华大学出版社), Thomson Learning


  • 测试技术
    在Intellivision平台上有一款曾经的畅销游戏名为Astrosmash,由于程序员在开发时假设没有玩家能得到达到一千万点,因此他并没有编写处理得分溢出情况的代码。而当游戏发布几周后,就有一些顾客开始打电话抱怨,当他们得分超过9999999点时,得分显示的是负数、字母或非数字符号。而事实上,由于该游戏允许玩家以慢动作玩游戏,使其更易于积累到高分数,因而更易触发该缺陷。由此,该游戏的作者约翰·索尔得到了一个深刻的教训:用户总会让你吃惊。
    理想情况下,玩家可能会希望开发者做完所有可能的测试工作,扫清所有可能触发的Bug;但事实上,由于开发周期、成本等因素,使得这成为一个不可能完成的任务,甚至潜在测试集本身的数量也不允许测试团队做完所有的测试。因此,他们创造了一些十分有用的测试设计技术,来帮助减轻测试的压力,以接近完美的测试。

    1)组合测试:
    可选择是游戏的一大魅力所在,如在典型的RPG游戏中,玩家可以选择人物的性别、职业、服装、武器、初始属性值分配和所属战斗阵营等。但是这诸多的可选配置就给测试团队带了一个极为头痛的问题。假设有2种性别(男、女)、2种职业(法师、战士)可供玩家选择,那么需要测试2(2×2)种可能组合;那么,如果额外地提供2种可选的服装(丝绸、皮革),就需要测试8(2×2×2)种可能。完全的组合测试是一个无比庞大的指数级增长,它既不现实也不经济。但其实,只要测试覆盖了足够的功能,就可以将测试集做得小一点。配对组合测试提供了这样一种可能。
    配对组合测试的基本思路是将可选值进行配对,得到测试集必须符合的条件集,那么如果缩小后的测试集满足这些条件,就认为它是正确的。比如上文提到的例子,它的测试集必须符合的条件就如下图(左)所示,而下图(右)则是一个符合要求的测试集表格,但它只有4条测试路径,却涵盖我们所关心的所有可选功能。
                  
    事实上,对于任意的可选参数集,都能通过一些简单可循的步骤创建任意大小的配对表格,生成令人满意的较小的测试集。并且,有一些预先构造好的表格模板可供选择,只需要简单地替换参数名称和值就能生成你想要的测试集;还可以选择组合工具Allpair,自动生成测试集。当然,这些并不重要,重要的是配对组合测试的方法可以节省掉大量的时间,将测试员从重复的冗余的测试中解放出来,而将精力投入到其他更值得关注的地方。
    不过,有时完全的组合测试是必要的,比如对于一些对游戏而言十分重要的特征值,但这通常只占总特征的不到10%。测试团队通常会选择混合的方式,即对关键特征作完全测试,对其他普通特征作配对测试。有时,10%关键特征会用掉80%测试路径,而90%普通特征却只能共享剩余的20%,但这是合理的,因为这些关键特征往往是全新的富有创造性的,同是也是最容易出错的。

    2)测试流程图(TFD):
    与组合测试不同,测试流程图是从游戏者的角度来描绘游戏行为的一种方式。如果多个游戏或特性中有相同的行为,测试员可以重复使用TFD;且只要正确的游戏条件和行为没有改变,TFD就保持不变,由此生成的测试路径就始终有效。
    TFD通常使用专门的开发制图工具处理和分析,它大致包括流程、事件、动作、状态、终结符等要素。一张较完整的TFD如下图所示:
           
    TFD需要配合数据词典才能发挥功效。数据词典对TFD集中每个独特命名的初始元素提供了详细的描述,尤其对于do条目定义了需要执行的操作,对check条目定义了测试员所需检查的目标。如定义check条目DropSound为:检查该项目是否已做丢弃声音。
    那么,TFD上的每一条路径就代表一个测试流程,可以通过简单地复制粘贴数字词典上对应的描述,获得一份详细的测试设计文案。对于测试路径有几种经典的可选策略:
    a. 最小路径:这种策略生成覆盖TFD中所有流程的最小路径,即TFD中的每一个地方至少被经过一次。它的测试次数在众多策略中是最少的,但它带来的问题是由于路径较长,有时直到项目的后期,才能发现一些早就在测试路径中存在的问题。
    b. 基线路径集:基线路径是一条从输入终端到输出终端的直接路径,在不重复或往返循环的情况下经过尽可能多的区域,由此往复直到基线路径集覆盖流程中所有的地方。它比最小路径复杂些,但能避免最小路径的延后发现缺陷的问题,不过,由于不同路径的区别操作可能造成最终发现的Bug成因暧昧。
    c. 专家结构路径:这一路径只是一个基于专业人员的经验制定的测试路径,它不必涵盖流程中的所有地方,但一定一次或多次经过专业人员认为最有可能失败或出现问题的地方。它往往是具有偏见的,但却很经济合算。因此,专家路径经常会联合前两者使用。
    测试流程图的方法对于测试游戏的状态转化、操作流程和其他可重复的功能尤其有效。

    3)净室测试:
    净室测试是从一种被称为“净室软件工程”的软件开发时间中提取出来的技术,其最初目的是在项目中运行软件,以进行平均无故障时间(MTTF)的测量。在游戏测试中,净室测试被用来解决游戏玩家在运行了许多时间后发现官方未公布的缺陷这一问题。它的目的在于发现、根除很有可能会被用户发现的缺陷。这些缺陷通常存在于玩家经常会使用到的游戏功能中,这也就要求测试团队按照一种玩家的方式去运行游戏的测试。
    首先要获得各个游戏功能的使用率。这可能基于测试员研究游戏玩家而得到的实际数据,也可能来自于个人关于这款游戏如何运行的期望,以及游戏生命周期中可能存在的玩法的变化。但,通常有三种定义和获取的方式:
    a. 基于模式:这指游戏的不同模式,如对战、RPG、多人等。不同模式的游戏针对的用户群不同,因此习惯、关注点、所需提供的功能都不尽相同,比如多人游戏的玩家可能会比单机玩家更多地在意玩家间的交互方式。
    b. 基于玩家类别:Richard A. Bartle将多用户玩家分为四类,进取者、冒险者、社交者和杀手。他们所热衷于的游戏功能就很不同,冒险者很关心游戏的艺术特效和美景,而杀手才不在乎,他只要体验杀戮的快感就万事大吉了。当然,还有其他的分类,比如键盘杀手和自定义者,游戏世界和真实世界是一样的,各种鸟都有。
    c. 基于现实:这种方式比较直接和直观,它通过记录玩家的偏好并统计,以用于进一步的测试和改进。
    得到使用率后,就可以利用其去选择测试步骤、数值、细节,且把它们按顺序排好形成能反映出玩家用法的测试情况。比如在使用组合测试时,使用率高的选项就应当在测试集中占有较大的比重;而在使用流程图测试时,使用率高的地方就应当被更频繁地经过。

    4)测试树:
    测试树提供了一种可以很好地反映存在于游戏功能和原理之间的树形关系。通过沿各种不同的从树的定点到树的每一个终点的路径测试,可以检测这些结构的行为方式。在游戏测试中,使用测试树有三种不同的目的。
    a. 测试用例树:它记录了测试用例和游戏特点、原理和功能之间的层次关系。这种测试已经成熟并且文档化了。每一次开发小组给测试者发送一个新版本,测试树就会被使用。测试者根据缺陷补丁或者版本中引进的新功能,决定其影响的范围以及要执行的测试。并且,测试用例树也很好地表型了游戏本身的构造方式。如下图所示,针对一款战役游戏给出了一个粗略的测试用例树。那么,当有关小型战斗游戏模式的代码被改动后,测试者就可以通过查看测试用例树明确地知道,他需要进一步地测试地图、玩家数量、种族、游戏选项和胜利条件等。当然,有时,这种检测可以是向上的,比如一张新地图的加入,就需要执行所有战役模式的测试。
            20105301632013
    b. 特征树:这种树用于反映游戏中的一些逻辑特征,或者说是游戏规则,典型地如RPG中常见的技能树、任务树和升级树等。特征树可以被很方便地翻译成测试文案,测试方法通常是通过替换每一个特征条件直到满足结论成立,这样,就能找到有缺陷的条件。如下图(左),给出了一个十分简单的技能升级的特征树,只有当人物的白魔法能力达到2级,同时黑魔法能力达到3级,才能修习蓝魔法。那么这一规则的测试就如下图(右)所示。
            20105301642134    20105301642333
    c. 设计测试树:这种树可以提高对一个复杂的游戏特征的理解,并且给潜在的混乱职能带来秩序,尤其是在关于与其他游戏规则,原理和职能交互作用的部分。测试员通过它生成测试用例,用以查明狭小范围内的游戏行为方式中潜在的缺陷。比如在RPG中,一种魔法会因为不同的人物、地点、武器和对象,而产生不同的伤害效果。那么,测试者就可以根据这些画出一个针对该魔法的树,修建无效的支路,最后依次执行所有的生成校验该魔法适当行为方式的测试。

    5)随机测试:
    随机测试(Ad Hoc Testing),有时又称综合测试(General Testing),是以一种较为主观的方法来搜索错误。这种方法认为,就算拥有最全面、详尽的测试计划和设计,依然可能会有疏漏;而随机测试,允许测试员作为一个个体,在对游戏执行系列客观测试的过程中,探测那些可能已出现过的调查路径。通俗地说,当测试员想着“如果我做#%&$,会怎么样?”时,随机测试提过了一个回答诸如此类问题的机会。
    随机测试有两种主要形式,自由随机测试(Free Testing)和定向随机测试(Directed Testing)。
    a. 自由随机测试:又称右脑测试,因为其是否直观和主观,是一种有专业游戏测试人员“即时”设计的“可与原始数据分离”的测试。这种测试往往需要锐利的眼光,一种游戏测试员的直觉;要求测试者在混乱中创造秩序,有目标有记录;并且始终保持孤身作战,这是自由测试的一个重要原则,避免集体审议,使得测试员保留个人作为玩家的特征,更容易发现一些违反直觉的游戏缺陷。
    b. 定向随机测试:这种测试方法使得测试者像一个侦探般工作,它通常用于解决某一特定问题或者查找特定解决方案,通常是因为一个或多个测试员报告了游戏中一个“偶然的”死机情况但原因不明后开始的,比如回答“场景切换的时候有时会崩溃”。测试员会先就结果作出假设,再一个个地验证它们。这个过程十分依赖测试员的经验和敏锐的嗅觉。共享信息是必要的,因为这方便地切断一些别人尝试过的假设,帮助更快的解决问题。

    6)性能测试:
    游戏性能测试与上文提到的所有测试技术所关注的焦点均不同。它关注的是“游戏运行得好不好”,而不是“游戏是否能运行”。差别是明显的,并且前者似乎更加重要,而且往往是带有主观特性的。性能测试的大部分是指对游戏平衡性的测试,也就是“游戏会不会太难或者太简单”以及“游戏中的各个可选功能是否均有可选之处”等。测试员所需要做的,是尽量准确地描述游戏的不平衡点,而不是给出过于精确的改善意见。
    还有一些性能测试可以通过外部测试进行,也就是给除了开发团队和测试团队之外的人玩,比如公司的营销部。这也就是我们经常看到的外部Beta测试,它包括封闭的和开放的。封闭测试的测试员经过仔细筛选,而开放测试通常在封闭测试之后进行,面向其他一些感兴趣的人群。外部Beta测试依赖于有效的管理,否则,会带来大量无用的数据。

好游戏取决于有创意的设计、严谨的测试和有力的营销。设计带来亮点,测试巩固亮点,营销贩卖亮点。虽然Bug是挖不尽的,但我们仍希望它是接近完美的。因此,如若没有deadline,测试团队的工作将是无穷无尽的。也因此,使得Time-critical的测试成为一项极为繁重的工作。这迫使业界总在探索更有效的测试技术,如何节约成本,如何避免遗漏,等等。缺陷触发、自动化测试、捕获/回放测试等技术相继诞生。那么,这样一个没有Bug的未来是否值得展望呢?答案犹未可知。

May 29, 2010

[读书笔记] 游戏测试 Part 1:基本概念

Book:Charles P. Schultz, Robert Bryant, Tim Langdell, Game Testing All in One(周学毛等译, 清华大学出版社), Thomson Learning


为着这学期软件工程课8000+字的Term Paper看的这书。前日去图书馆原是想借些正经软工书的,翻了满架子的书竟是本本写得都像畅销书,还真如众人所说的,真水。想看些架构设计的书,竟也没找着。稍有些质感读起来也不太枯燥的,就只有一些游戏方面的书,有图,还有些我知晓的例子。那便看吧。

测试为什么重要呢?因为游戏会出错,出各种各样的错,并且即使经过了漫长的尽可能全面的测试,游戏依旧会出错。但这恰恰说明在发布前的测试是十分必要的,不管是对于游戏出版商,还是对于开发团队而言。一款出色的游戏会得到褒奖,而一款充满Bug频频跳闸的游戏则会给开发团队带来漫天的骂声,销售额和利润也随之蒸发。

测试为什么对于游戏尤其重要呢?其实测试对于任意一款应用软件都是相当重要的,但是没有一款应用软件像游戏这样拥有庞大、多样、富有压力的客户群。不要指望玩家规规矩矩地按照手册上写的点击菜单,你永远都无法完全预测到每一个玩家所有可能的变态操作——他们可能在物品交易的过程中突发奇想地丢掉正在交易的物品,而导致玩家数据错误。因此,游戏测试是任重而道远的。
 

  • 游戏测试员的任务
    作为一名出色的游戏测试员,需要从一名游戏玩家开始,但绝不仅止于此。游戏测试员需要诀窍来发现问题、记录并报告Bug、报告测试进展和帮助开发者发现并确定Bug具体位置。在游戏发布之前,测试员需要反复地做以下这些事情:
    201052710520821 

    1)Play:游戏测试员的“玩”较普通玩家是少有选择性的,测试方案从一开始就规定了测试的目的和步骤,如查探某一游戏中的地图、检查某个特定的原则是否得到执行、或者寻找某一类特殊的问题。有些测试甚至是十分具体的,比如对游戏界面的测试,就依赖于敏锐的观察和对细节的注意,并且往往需要循环重复一些枯燥的按钮和下拉动作,以确定是否存在某些不合理或错误的操作响应。

    2)Identify:游戏测试有两个目的,一为找到游戏代码或设计中的缺陷,二为说明游戏中的各个部分能否正常运行。当在测试过程中发现了问题,游戏就相对地“失败”了,这时需要测试员详细地描述发生该问题的过程和结果。
    当测试游戏的同一部分时,不是每个测试员都能发现同样的缺陷。心理学上认为这是由人的不同性格造成的,并给出了有效的性格测试工。这个工具可以识别一个人是裁判还是感知者。裁判善于组织和作计划,喜欢井然有序和可预测的测试环境,专注于测试内容的细节,提供详尽的测试报告,适合测试用户手册、脚本;感知者则喜欢采用非常规的游戏玩法,测试多种可能和游戏的真实体验,往往不受计划约束,却能发现一些意想不到的珍贵Bug。这两种人是互补的,因此在一个测试团队中往往需要这两种人。

    3)Amplify:这里的“放大”指的是尽可能地使缺陷在第一次被发现时就完全暴露出来,以减少用在这个问题上的时间和成本,这对开发者通常是有益的。为了达到这个目的,通常需要做到两点。首先,尽可能早地执行测试,如当一些新的人物、关卡、功能或子系统第一次被引入时就应当马上进行测试;第二,当在测试过程中发现某个Bug时,应当检查每一个可能触发该Bug的地方,如代码中所有调用包含缺陷的关卡、功能或子系统的地方。

    4)Notify:当测试人员发现问题且能描述它影响游戏的方式时,就需要记录此信息并就此向开发人员通报。这一过程通常通过缺陷追踪和管理软件实现,如业界常用的DevTrack。一份完整的通报包括以下几个重要部分:

    a. 标题:一个描述性强的标题通常很有用,它帮助开发人员快速地定位此缺陷的大致内容。好的标题通常需要包括一些重要的要素,如事件、人物、方式等。这就和撰写报纸的标题一样,像“杭州地震了”这样的标题是不适用的,它让人产生迷惑。而“5月22日杭州发生里氏8级大地震”这样的标题则合格得多,它恰当地表达了这则新闻的重要性和爆炸性。有时还需要更多的细节,如“造成90人死亡”和“城中30余处房屋倒塌”等。

    b. 描述字段:这里包括测试员能及的所有有帮助的细节,人物(战士)、事件(嵌入到内墙的上部)、地点(训练厅)、时间(拜访符咒训练者后)和方式(跳跃)。有时,如果可以,还会描述问题可能的解决方法等。

    c. 缺陷的优先级:优先级的名称和含义对项目而言可能各不相同,但概念是相同的,都是根据其重要性对缺陷进行划分,从而决定它是否被优先处理。“紧急”的Bug可能导致玩家信息的丢失、终止或异常中断游戏等重大缺陷;一个“高”优先级的Bug通常是导致某些严重后果的缺陷,如提交了请求但不能得到请求的东西;“中等”缺陷导致明显的问题,但不会危及玩家的奖励或关卡;“低”优先级的Bug则是正对非常微小的缺陷而言,如一些不容易发觉的拼写错误。但应当注意的是,Bug的严重性等级和优先级是有所区别的,比如主菜单中的拼写错误并不会导致什么严重的后果,但却是一个急需改正的Bug。因此,大多数游戏公司会在对Bug订正排序时联合使用严重性和优先级。

    d. 缺陷的类型:包括需求修改、文档问题、矛盾报告、进一步增强、微小改进、新特征、第三方错误等,对确定缺陷的路径和处理缺陷而言有重要的意义。通常缺陷管理软件会提供一些可选的分类。

    e. 备注:这确保测试员通过添加文件的形式,提供所有有帮助的内容或信息,包括日志文件、包括Bug的录像、操作系统的弹出窗口和错误代码等。

    5)Testify:游戏测试员的工作只是发现并通报缺陷,而真正区分缺陷的优先级的权利则掌握在变更控制委员会(CCB)手中。CCB监督和促使最要紧的缺陷得以完成修复,从而在项目期限到时能交付一个最符合要求的游戏。其成员一般包括来自发展部门、测试部门和项目管理部门的代表,他们对Bug进行仔细检查,对其优先级打分,再交付修改。值得一提的是,这里涉及到游戏测试中另一个重要的原则——有选择的(Optional),有时因为项目期限的临近,使得许多团队放弃修复一些有难度的缺陷。

    6)Verify:这一步指的是在Bug被修复好之后,有测试人员再次对性测试一次,以确定其是否被完全和有效地改正。
     
     
  • 游戏缺陷的类型
    由IBM公司开发的正交分类(ODC)系统定义了多种软件缺陷的分类方法,其中与游戏较相关的大致有八类。每一种缺陷类型或者是执行结果不正确,或者是缺少代码。

    1)功能(Function):功能错误是一种影响游戏性能及用户体验的错误,可能由提供这一功能的代码丢失或不正确造成,如,在触发某一人物技能后,显示技能停留剩余时间的时间条的缺失。

    2)赋值(Assignment):赋值错误指程序所使用的值被错误地初始化或设置,多数发生在游戏开始、进入一个新关卡或一种游戏模式时,典型地如在策略游戏中,对开始的位置单元和可用资源的初始化。错误的赋值将导致对游戏平衡性的破坏。且有时这种错误是隐藏的,难以有程序员发现的,只有通过测试才能找到。

    3)检查(Checking):当代码在被使用前缺少适当地验证数据时,就可能产生检查类型的缺陷,简单地如边界比较,使用<=代替<。

    4)时间控制(Timing):时间控制缺陷与资源的共享、资源的实时管理相关。良好的时间控制应当在加载某些大型资源时,给出进度条,显示正在进行的操作。通常RPG游戏中在人物启动某项特殊技能的时候会给出一个短小的动画,但往往技能切换完成得会比动画快得多,这时错误或缺失的代码讲导致在动画完成前,技能就被启动,这是违反游戏的世界观原始设定(比如关于念魔咒隐身),这是一个典型的时间控制缺陷。

    5)构造/包装/合并(Build/Package/Merge):这类缺陷是由于配置游戏源代码库系统,变更游戏文件管理,或版本识别和控制引起的错误。良好的版本管理和习惯约定能减少或避免出现这类缺陷。

    6)算法(Algorithm):算法缺陷包括一些计算过程或者选择结构中出现的有关时间复杂度或正确性的问题,主要涉及逻辑控制、AI、数值计算、渲染控制等方面。这类缺陷都大部分涉及到游戏功能,其中一些还是隐藏功能,因此大多会考虑写一个专门针对某一算法缺陷的查找脚本,做连续地测试,而不是一个一个地手动测试。

    7)文档(Documentation):文档缺陷不是由不适宜的代码导致的,而是存在于从文件中重新得到的字节型数据或定义的常量,比如在屏幕上显示的文字、音频或供函数调用的读入参数。这些缺陷只能通过仔细地阅读文本、听音频、检查文件和图形,才能被检测到。

    8)接口(Interface):接口缺陷可能在任何一个信息被转移或交换的地方发生。但通常,它的存在是由于模块之间的调用方式有误,比如被传入的参数与调用例程不匹配,或者在传入时使用前没有做合适的数值范围或类型检测等,都可能导致接口缺陷的产生,而且这些缺陷往往是细小且不容易发现的。
     
     
  • 测试阶段与过程
    虽然游戏的大小不等,开发周期也各不相同,小到只需数周就可完成的手机游戏,大到一些大型的MMORPG或平台游戏,有时需要几年的开发时间,甚至屡屡跳票(如暗黑3)。但不管游戏有多大、生产周期有多长,其测试始终遵循相同的基本结构。

    1)试生产阶段:对测试可能的认知是认为测试是在游戏的一个成功部分被开发之后的某一个时间开始的,但事实上,测试始于项目开始之时。许多发生在项目的早阶段的事情,将会为以后测试的好坏定下基调。最好能在项目一开始,就将较多的努力和技术应用于测试活动来修正错误,而不是后来对其做更多的测试,来努力修正它们。
    在这一阶段,需要制定合理的测试计划,包括:决定测试的范围、任命测试主管、决定阶段验收标准、参与游戏设计检查、建立缺陷追踪数据库(关键)、起草测试计划草稿和测试设计。除此之外,还要对游戏原型作模块测试,并且根据测试要求招募或雇佣额外的团队成员。这一阶段的测试结果往往是不成熟的,但却对未来的测试工作有着深远的影响。

    2)测试的开题阶段:这一阶段分为两个部分,测试员准备和开题会议。测试员准备的步骤和开题的议程都记录在测试开题的清单上,可以看到,测试员需要在开题前通过阅读说明书或文档了解被测试的游戏特征,需要测试所需的设备、文件和程序,最后需要阅读由测试专家书写的测试文案。
    开题会议是一个交互式的会议,每个测试的开题都是改善对测试的理解、测试质量和测试执行的机会。通过会议当中的讨论,能提前发现一些在未来的测试过程中可能遇到的问题,并找到补救措施。有统计表明,开题会议实际上节约了测试时间,开题测试的速率是非开题测试速率的1.4倍。

    3)α测试阶段:在α阶段的游戏是成型的,游戏的特征已经被测试和校订了,各种素材也被整合过了。这是整个游戏第一次完备的测试,因此,这一阶段的测试是最繁忙的,也因此严格坚持测试套件中的内容是十分关键的,它能让整个测试过程井然有序。在α阶段,游戏的所有模块至少应该被测试一次。业界有公认的详细的α阶段测试入口标准,涉及代码的平台TRC通过率、QA要求、软硬件相容指标和美术要求等,只有符合该标准才能进入α测试阶段;类似的,也有β测试入口标准和最终测试入口标准等,这对整个游戏的测试阶段起到良好的规划作用。

    4)β测试阶段:此时,开发团队已经在极大程度上停止创造新代码和新素材,而将关注点转移到如何使游戏更完美,也就是到了识别和修正Bug的时候了。在β测试的早期阶段,会有团队以外的玩家参与测试,但大部分的时间会被花在报告Bug并测试装载上。
    这里有一个值得一提的时间点,称为“设计锁定”。当设计锁定状态被宣布后,游戏大方面的测试都已经结束,平衡问题也得到了最好的解决,团队的关注点变为反复地通过实际测试案例来检验版本。在这一状态到来前,项目组需要作出一些重大的决定,如是否要执行最后时刻的特征强化(引入设计师的新构想)、是否砍掉似乎不那么有趣的关卡、哪些Bug将被忽略(难以决定,但时间是有限的)。

    5)最终测试阶段:进入这一阶段的游戏出于典型的发布状态,所有的已知一级Bug(崩溃、暂停、主要功能失灵)和大多数的二级、三级Bug被修复。游戏被宣布处于“代码锁定”状态,测试员充当游戏者和项目组的最后防护线。测试团队将最后一次,在时间允许的条件下,尽可能多次执行所有测试套件。任何在最后阶段中发现的严重缺陷都将导致候选版本被拒绝,Bug修正后最终测试必须从头再做一次。此时,整个团队都处于极度的疲倦中,但唯有大踏步地前进才是最好的取得胜利的方法。

    6)发布证明阶段:这一阶段的测试通常是由平台制作商(任天堂、索尼)来完成的。其测试游戏的代码是否符合TRC,其功能性和稳定性是否合乎标准。通常,此时还会有一些Bug被发现,然后开发商将会与平台经理的客户就Bug进行讨论,开发团队将被要求修复那些“必须被修复”的Bug。这一过程有时会反复多次,直至候选版本被平台制造商认可,成为“正式版”。

    7)公布后测试阶段:游戏发布后,测试依旧不会停止。这也就是我们通常看到的开发商不断公布补丁的时刻,但并不是所有的补丁都用于修复Bug,有时它们是用来为游戏添加新特征的。这一过程会一直持续到游戏的生命周期结束。
     

February 12, 2010

[读书笔记] 人工智能中的不确定知识与推理 PART 2:关于时间的概率推理

BOOK:Stuart Russell, Peter Norvig, Artifical Intelligence: A Modern Approach(中译第二版,姜哲等), Pearson


在静态世界中,每一个随机变量的取值都是唯一固定的;而有时问题是动态的,环境状态会随时间不断变化,比如考虑病情的发展,因此有必要对时间上的不确定性建模。我们将状态的改变过程描述为一系列快照,每一个快照(或时间片)都描述了世界在某个特定时刻的状态,包含一个随机变量集合,其中一部分是可观察的,如证据变量Effect,另一部分是不可观察的,如Cause。为了方便标记,一般假设时间片间有一个固定的有限时间间隔,以整数标记。符号U1:3对应变量U1,U2,U3。

  • 马尔可夫假设
    马尔可夫假设认为,当前状态值只依赖于过去“有限的”已出现状态历史。这一假设使我们得以避免指定数目无界的条件假设表(过去的历史是无限的)。满足这一假设的过程被称为马尔可夫过程或者马尔可夫链,最简单的也应用最广的是一阶马尔可夫过程,即当前状态只依赖于相邻的前一个状态,与更早的状态无关:
          clause53    | 转移模型
    另外,也假设时刻t的证据变量只取决于当前状态:
          clause63    | 传感器模型
    一阶马尔可夫的假设在大多数情况下都只是一种近似,而且往往是太不精确的,有两种可能的弥补方法:1)提高马尔可夫过程的阶数;2)扩大状态变量集合。但是可以证明,提高阶数,总能够通过增加状态变量的个数重新形式化,以保持阶数不变。
  • 基本推理任务
    1)滤波和预测(Forward)
    滤波指在到目前为止所有已知的证据下,计算“当前”状态的后验概率分布,即已知直到时刻t的滤波结果,根据新的证据clause11 计算t+1时刻的滤波结果。滤波的过程可分为两步:首先,将当前状态分布由时刻t向前投影到时刻t+1;然后,通过新的证据进行更新。
           clause1211
    式子的第一部分是传感器模型,第二部分是一个求和式中,其中第一个因子是转移模型,第二个因子是时刻t状态分布。求和式完成滤波的第一步,总式子完成第二步。并且,可以认为因子2是沿着变量序列向前传递的“消息”f1:t,在每次转移时得到修正,并根据新的证据进行更新,也就是前向递归:
           clause1320
    预测指计算“未来”某个状态的后验概率分布,可以认为是没有增加新证据的条件下的滤波:
           clause148
    这也是一个前向递归,并且这个计算只涉及转移模型而与传感器模型无关。可以证明,预测结果分布会在将来收敛到一个不动点,之后一直保持不变,即稳态分布。收敛的时间称为混合时间,转移模型中的不确定性越多,混合时间就越短,未来也就越模糊。

    2)平滑(Backward)
    平滑指在到目前为止所有已知的证据下,计算“过去”状态的后验概率分布,也可分为两步:时刻1到k的前向递归和时刻k+1到t的后向递归。
            clause1514
    这个求和式中的因子1是传感器模型,因子3是转移模型,因子2是后向传递“消息”:
           clause1610  
    后向递归和前向递归复杂度相同,每次更新所需的空间和时间都是常量,与时间t无关,而是取决于状态空间的大小以及问题所需的特定时序模型。我们可以通过记录整个序列进行前向滤波的每步结果,来降低全序列平滑的时间复杂度为线性,这也就是Forward-Backward算法,先从时刻1到t前向滤波,再从时刻t到1后向平滑。这个基本算法有两个主要缺点:它提高了算法的空间复杂度;它需要修改才能工作在联机环境下,即对于不断新加入的证据,平滑以前的时间片。

    3)寻找最可能序列
    寻找最可能序列指给定一系列观察结果,找到最可能生成这些观察结果的状态序列。应当注意到,平滑计算得到的是“单个”时间片上的后验概率分布,而寻找最可能序列,需要考虑所有时间步上的“联合”概率分布,即
           clause913
    典型地,考虑动态规划的思想,寻找一条以每个时间片上的可能状态为节点最大化后验概率的路径,路径上的状态就组成了最可能序列。在一次前向的遍历中,计算并记录到达每一个状态的最可能路径的概率(通过其父节点上的最可能路径概率记录),并标记产生该概率的父节点。遍历结束后,通过标记就可以回溯到这条最大化概率的最可能路径。这就是经典的Viterbi算法,其空间和时间复杂度都是O(t)。
     
  • 隐马尔可夫模型Hidden Markov Model
    HMM指用“单一离散”随机变量描述过程状态的时序概率模型。该模型的可能取值就是世界的可能状态。多个状态变量可以组合成一个单一的“大变量”,以单个变量取值构成的所有可能元组为取值范围,来保持HMM框架。
    HMM使得所有的基本算法有一种非常简单而优雅的矩阵实现(优雅这词用的,作者太有爱了)。令状态变量用整数1,…,S表示,其中S为可能状态的数目,那么,转移模型就可表示为一个S×S的矩阵T,Tij表示从状态i转移到状态j的概率;对每个时间片t,传感器模型就可表示为一个对角型矩阵Ot(证据取值已知,因此为对角型),Oii表示当状态为i时生成证据et的概率;前向消息和后向消息用列向量表示:
           clause177 
    矩阵的形式化还揭示了改进算法的机会(值得借鉴的一句话)。
    我们可以通过取逆的方式调换等式位置,将前向消息修改为后向传递。那么Forward-Backward算法就可以被修改为:先执行标准的前向过程计算f t:1,但抛弃中间过程,然后b和f同时执行后向计算,得到平滑估计。这种修改降低了算法存储空间的需求,但它要求转移矩阵必须是可逆的,传感器矩阵也是可逆的,即所有观察值在每个状态下都是可能的。类似的,还可以修改平滑算法使之支持固定延时的联机平滑(Fixed-Lag-Smoothing算法)。
    HMM被广泛地应用于语音识别、动作手势识别等领域。
     
  • 卡尔曼滤波器Kalman Filter
    卡尔曼滤波用一些“连续”变量来描述系统的状态(可以是多元的),然后选用合适的条件概率密度“函数”来表示转移模型和传感器模型,典型地,如线性高斯分布。假设位置X由速度和前一时间点的位置决定:
           clause18[6]
    那么如果增加一个高斯噪声,就得到一个线性高斯转移模型:
           clause19[14]
    并且,其给出的单步预测分布也是高斯的,对给定新证据进行条件化后得到的更新分布也是高斯的。一个d元高斯分布的卡尔曼滤波公式传递的“消息”是一个d元均值向量和一个d×d协方差矩阵,其与通用滤波公式或HMM模型的滤波公式的功能是相同的,但由于高斯分布的特殊本质,附加了一些有趣的性质,比如方差值的更新与观察值无关,并且其会很快收敛到一个固定的值而大大简化后续的计算过程。
    卡尔曼滤波最常见的应用是物体运动轨迹的跟踪,甚者能够应用于任何通过连续状态变量和噪声测量来刻画的系统。但是注意,这些系统必须是“光滑的、表现良好”的,并且允许追踪者保持和更新一个合理近似于真实后验概率分布的高斯状态分布。这是因为卡尔曼率滤波器将高斯均值附近的状态Xt当作局部线性的,而“不光滑、表现不良”的系统是高度非线性的,比如Xt+1的取值会因Xt与环境中某值间的相对关系而改变,参考书中鸟撞树干的例子。这种情况下,就需要考虑使用切换卡尔曼滤波器,并行多个卡尔曼滤波器,再根据每个滤波器对当前数据的适合程度,对预测结果取加权和。
     
  • 动态贝叶斯网络Dynamic Bayesian Network
    DBN中的每个时间片都具有任意数量的状态变量和证据变量,HMM和卡尔曼滤波都是DBN的特殊形式。DBN通过将复杂系统的状态分解成一些组成变量,充分利用时序概率模型中的稀疏性,使得其比纯马尔可夫模型更适合大规模系统。DBN需要指定状态变量的先验概率、转移模型和传感器模型,后两者还需要指定相继时间片之间、状态变量与证据变量之间的链接关系的拓扑结构,如左下图所示。
             clause19[22]       graph5[4]
    DBN仍然是贝叶斯网络,因此变量消元、似然加权等推理方法仍然适用。但是DBN的精确推理是不适用的,随着规模的扩大(序列过长),变量消元的因子增长将是指数级的。近似推理中的似然加权也不是很好的选择,与真实的事件序列保持相当接近的样本比例将随着观察序列长度t的增加而呈指数级下降,举个极端的例子,以老板是否带伞来判断是否下雨的DBN,即使老板天天带伞,也仍然会产生有无尽的晴天的幻觉。
    一种比较有效的算法族是粒子滤波,它的工作机理是:首先根据时刻0的先验分布进行采样得到N个样本构成的总体,然后对接下去的每个时间片,对于每个样本通过转移模型使之向前传播,再赋予新证据的似然值进行加权,最后对总样本进行重采样,某个样本被选中的概率与其权值成正比,如右上图所示。例子滤波是高效的,它通过常数数目的样本维持对真实后验概率的良好近似,并且由于它是一个采样算法,能够很容易在混合的和连续的DBN中使用,被广泛应用于复杂的运动模式跟踪以及市场预测。