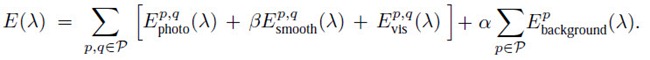November 16, 2010

奥利奥不能没事乱咬了

冬天开始许久了,都说今年是千年极寒,但是专家说寒不寒的要等到冬天结束才会知道。上海某正保暖改造的旧高楼着了,几个老太老爷从十几楼跳下脚手架上避火,死了五十三重伤了七十,消防队员说喷水其实不能灭火我们喷喷就是为了让群众觉得我们还是在做事情的。方便的咖啡奶茶不敢乱喝了,奥利奥不敢没事乱咬了,雀巢在国外说氢化植物油害人在国内却好好好卖,麦当劳说不关我们的事。然后今天,蜂蜜有害,强生也含二恶烷了。账户里只有虽然四位但1字打头的存款,我每天都不只一次想到,这世界里的至少中国大陆没法活了。移民什么的只有等到爸妈都去了才能考虑,那也是二十三十年后的事情,说不定到那时韩国人都统治世界了。

老妈电话里老问忙吗,我想了想只有回答就这样。不忙吗?忙的,每天实验室待到10点,每周休息0.5天,工作50小时才刚刚够到老板心里认真工作的底线边缘。忙吗?那要看对忙的定义是啥了,一年300天如此,别人的忙在你这里是日常,不忙是太闲了。这世界变化太快了,你如何让一个每天油盐酱醋9点半就打瞌睡的淳朴老妈,理解你12点睡觉叫早10点半了还在街上买炒粉干的行为。

还有十几天MHP3就发布了,可我2G还在下位混,看到轰哥就怕。说起来,这游戏当初第一次玩过就删了,觉得无聊而且丑,后来不知不觉又捡回来了,现在睡觉前每日一怪砍得不亦乐乎。多玩论坛上见到好多人都是这样,总要辗转反侧几次才能发现MH的美。今天在多玩上看到某MH饭的2G回忆录SP,我这个长年潜水的人都忍不住回了贴,剪得赞,BGM配的更是赞,热血,还励志。我总是想,要是这现实世界,有和做猎人一般单纯就好了,哪有那么多花花肠子,不过就是你死我活,还要说什么友谊第一,虚伪!

只要你骨子里有那么一点点热血,绝对会爱上这燃到内牛满面的BGM,虾米地址狂点我!

码完继续看论文。

November 2, 2010

[论文笔记] Multi-view video based multiple objects segmentation using graph cut and spatiotemporal projections

Paper:Qian Zhang, and King Ngi Ngan. Multi-view video based multiple objects segmentation using graph cut and spatiotemporal projections. In Journal of Visual Communication and Image Representation, Pages 453-461, 2010.


问题描述:这篇文章旨在从多视点视频中分割多个前景物体——Interested Objects(IOs),也是一个综合多通道信息的大算法框架,如下图所示。吸引人的地方在于据作者所述,该算法表现出不俗的精确度、效率和鲁棒性。在架构5个摄像头的实验中,处理640*480分辨率的视频能达到30fps的梦幻速度(不知是否包括预处理和离线操作)。并且,题目中的多前景物体分割也很具吸引力,虽然就实验结果来看,作者并没有考虑前景物体的重叠遮挡情况。

11-2-2010 7-44-07 PM

  • 预处理阶段,做色彩归一化和定标,杂务。
  • 离线阶段,生成一些用于在线阶段的辅助信息:Motion field[1]、Disparity field、Occlusion map、Depth map和Combined occlusion map(详细描述见论文),三维重建相关,可参阅其他文献。
  • 关键视点初始帧操作:
    1) 文章引入一些High-level Feature到Saliency model,如Motion、Depth等。Saliency model(SM)旨在表现人会更关心一幅图像中的那些部分,比如相较于背景更关心前景、更关心运动的物体、更关心图像的中间部分或色彩明艳的部分等。因为人比起机器,更懂得识别场景的语义,所以学人,总是没错的。那么,SM中拥有较高值的块将触发下一步的操作,如下图。
    11-2-2010 9-04-39 PM
    2) 基于Graph cut的多前景物体分割。文章修改了基本的能量方程(事实上,每篇文章都改),在色彩和平滑度的基础上增加了对像素重叠(前景物体边缘是重叠的高发地带,因此联合重叠部分CO比可见部分更有可能是背景)和对比度变化[2]的考虑。另外,对于每一个前景物体,graph cut是分别进行的,在一个Object Rectangle中,用于限制物体的最大区域。and,就文章的实验结果来看,的确比基本的能力方程更有效,如下图。
    11-2-2010 9-05-02 PM
  • 多视点视频前景分割:
    1) 根据上一步得到的关键视点初始帧轮廓,可以通过Visibility Constraint得到其他视点的粗略轮廓;
    2) 类似的,可以通过Motion Projection来获得后继帧的粗略轮廓;
    3) 对于不确定的前景物体边界,再基于像素的activity measure(运动的变化量)应用一次Graph cut来得到精确轮廓线。

首先,文章的实验结果是暂时所见到的诸多segmentation文章中最美好的,虽然只有两个实验用视频,且鉴于以往经验,论文所述的实验结果和conclusion在实际重复其工作时,总会打上些折扣。
其次,私以为,文章存在以下limitation:1)没有考虑前景物体间的遮挡,至少文中并没有说明或证明算法能解决这一问题;2)由于文中算法对除关键视点初始帧以外的其他帧和视点,采取了基于关键视点初始帧轮廓投影的方法,来得到粗略轮廓,也就是说,可能存在由于关键视点初始帧操作崩坏,而带来的集体崩坏现象。那么,我们有理由怀疑文章算法对其他视频的适用性;3)同2)原因,文章算法很可能无法简单地适用于前景物体变化较大的视频,比如突然多了一个人;4)鉴于真实经历,相机定标等杂务,绝不如其在文章中的比例和重要性一样轻巧,并且往往有可能是带来后继问题最多的一部分。

综上所述,虽然文章很美好,拿到实际应用中,总是堪忧的。


[1] L. Itti, P. Baldi, A principled approach to detecting surprising events in video, IEEE Int. Conf. Computer Vision (2005) 631–637.
[2] J. Sun, W.W. Zhang, X.O. Tang, H. Y Shum, Background cut, ECCV (2006).

[论文笔记] Joint 3D-Reconstruction and Background Separation in Multiple Views using Graph Cuts

Paper:B. Goldlcke, M.A. Magnor. Joint 3D-reconstruction and Background Removal Separation in Multiple Views Using Graph Cuts. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition(CVPR ‘03), page 683–688, 2003.


问题描述:这是篇03年的老文章,老耿给的且瞅着作者长得挺不错(点我点我)——其实前面的才是重点,通读了一下。文章的亮点在于同时处理Depth map estimation和Background seperation问题,当然是Multi-view的,而且是精确定标的(不像09年那位拿硬件捣鼓,这篇文章是基于图像像素算算算出来的)。文章认为,如果已知每个像素的深度,那么只有那些深度小于背景的像素,才有可能属于前景;同时,考虑背景因素可以提高三维重建算法的鲁棒性。

帅气一作的强项是三维重建,因此前背景分割则比较像站在他人肩膀上的那位。作者在文中以及Abstract里反复说文中的优化算法衍生于Kolmogorov等人的Multi-Camera Scene Reconstruction via Graph Cuts,他们做的工作是Generalize,所以文章本身的算法描述部分没什么亮点。它的好看之处在于作者对二维点的三维关系和三维点的二位投影的优美定义和量化。

11-2-2010 4-00-23 PM 深度的定义:如果有个面P,所有的摄像头都在P的一边,且朝向P的另一边,那么可以认为在P上的点拥有相同的深度D。这个深度其实是一个离散的、相对的概念。

拓扑结构的定义:Np,指在Pk上与p点相邻的所有,能量函数在这个集合上应当是连续的;Cp,指包括p点的相邻点,用于作为判断图像一致性的标准。

几何结构的定义:<p, l>和<q, l>相交,指p, q来自不同的摄像头,且p是图像上最接近<q, l>在cam j上投影点的点,这种二元关系组成集合打不出来的花体D,其中<p, l>指点p的三维点。(1)
<p, l>遮盖<q, l’>,指满足(1)关系,且Id’<Id(也就是深度小),这种二元关系组成集合打不出的花体J。

然后就可以帅气地定义能量方程:
11-2-2010 4-26-31 PM
其中,第一项指图像一致性,即通俗点讲,如果p,q是同一点,那么其相邻点集合Cq, Cq应该差不多;
第二项指平滑性,即通俗点讲,如果p, q相邻,且它们的颜色也差不多,那么它们的深度也应该差不多,或者在是否是背景这一点上应该是一致的;
第三项指可视性约束,即通俗点讲,如果cam j看到深度为Id的点p,其为<p, l>的投影,<p, l>投影到cam k上最近为q点,那么q点的深度不可能比p点大;
第四项指背景属性,即通俗点讲,如果一个点是背景,那么必须有和背景一样的深度。
具体的量化见论文。

然后,balabala定义完后,就是Graph Cut上演最小能量优化,略。
11-2-2010 4-42-54 PM
11-2-2010 4-43-07 PM
算法结果上来讲,比03年同期的分割算法好些,但是速度嘛。。作者当年用1.8GHz的Pentium III Xeon做个初始化要30秒,320*240的图片处理需要约4次迭代290秒,有点慢的说。。不过人家当年可没有GPU加速的Graph Cut可以用,CPU也够呛,所以放到现在实现起来有多少效率也不知道。不过,鉴于大多源自重建算法的图像分割效率都不怎么样,私以为这算法在效率上是没什么看头的。其余,精度尚可,鲁棒性其实论文说什么都是假的,灵活性倒是高——不用添置新硬件,软件什么的改改还是方便的,总能找到能尝试优化的地方——虽然大多时候是有限且低效的。

以上。

November 1, 2010

[论文笔记] Combining Color, Depth, and Motion for Video Segmentation

Paper:J. Leens, S. Piérard, O. Barnich, M. Van Droogenbroeck, and J.-M. Wagner. Combining color, depth, and motion for video segmentation. Proceedings of the 7th International Conference on Computer Vision Systems: Computer Vision Systems(ICVS ‘09), pages 104–113. Springer, 2009.


问题描述:本文引入TOF摄像头(文中指PMD-camera,TOF-cam的一种),对视频场景做新的解释,并结合传统的彩色分割技术、动态分割技术,做前背景的分割。
传统摄像头提供彩色图像,而PMD-camera提供物体距离、信号强度、信号密度等和物体空间位置相关的场景属性,是一种十分有前景且年轻的技术。不过同时,TOF摄像头也存在一些暂时无法解决的问题,如信号的噪声、受传感器大小限制的分辨率(160*120)、以及估算距离的致信区间、还有定标难等问题。尽管如此,这种新硬件对于交互领域还是非常有趣和有价值的。
11-1-2010 4-25-19 PM 
文中的方法基于像素做前背景分割,避免对场景内容的假设,也不需要任何3D模型的支持。方法结合背景相减技术(Background subtraction tech.)对获得的区域图(Range map)进行处理,获得更鲁棒和准确的分割结果。比如,当人物的颜色和背景的颜色相近时,基于色彩的传统背景相减技术就可能失效,而基于红外信号反馈的PMD-camera就可能返回可用的结果;而,当人物和背景的材质相近,也就是说对红外信号的吸收相近时,传统背景相减技术就能弥补PMD-camera的失效。

作者简单地将两种摄像头上下捆绑,采用简单地仿射变换来对齐图像,回避了TOF-cam定标难的问题。文中采用的背景相减技术引用了09年O. Barnich等人发表的ViBe - a powerful random technique to estimate the background in video sequences 一文,其最显著的特点在于通过一种随机策略来建立基于样本的背景估计和一种全新的策略在相邻的像素间传播信息和状态。
11-1-2010 4-44-01 PM 
文中提出传统技术和PMD-camera联合策略还是比较简单易懂的,如上图所示。图中,T&I 指代Transformation and Interpolation,G.R.指代Geodesic Reconstruction(待考证是什么意思)。究其本质,意在让两种方法互补缺点,如下图所示。据文中所言,能达到实时的速度,较之一些结合立体视觉和颜色技术的算法目前所见最多只有9fps的速度,还是很有吸引力的。
11-1-2010 4-44-23 PM
11-1-2010 4-44-42 PM

October 20, 2010

[论文笔记] Action as Space-Time Shapes

Paper:Moshe Blank, Lena Gorelick, Eli Shechtman, Michal Irani, Ronen Basri, Actions as Space-Time Shapes, IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI ’07), 2007

问题描述:文章将人在视频中的运动看作是身体(torso)和四肢(limbs)做连续运动的轮廓图的集合,因此可以用Space-time volume(STV)来表示人的运动。文章将2D图形的分析方法借鉴到3D,应用泊松方程(Possion Equation)于STV,再提取如Space-time Saliency、Action Dynamics、Shape Structure和Orientation等时空特征。这些特征可以用来检测和识别人体的动作(Action Recognition/Detection)以及动作的聚类。

传统动作识别的方法虽然也能得到不错的结果,但各自都存在一些局限。如,基于光流的方法会受到空洞、表面平滑度、不连续性的影响,基于特征跟踪的方法在存在自遮挡、外观改变和重初始化问题的情况下会面临很多困难,而基于关键帧或关键特征的方法则忽略了动作的时序特征,另外一些基于周期性分析的方法则只限于识别据有周期规律的动作。因此,近期一些动作识别的工作都将眼光放在了同时据有时序和空间特征的STV上。(译自原文)

STV由一系列从视频中提取的2D轮廓连结而成,同时包括了人体的姿势和动态信息。不同于一些相似的基于STV的论文——他们基于STV的表面提取特征,这篇文章的方法应用泊松方程来提取STV的各种特征(包括局部的Space-Time Saliency、Space-Time Orientations特征和全局特征),得到其在应对轮廓边界可能存在的噪声时显得更加鲁棒(得到的结果类似于动作的粗略骨架,对于分析动作很有用)。
   

这种方法的主要优点在于:
1. 不需要帧间对齐(Video alignment);
2. 计算复杂度与STV的采样点个数线性相关,文中言其处理110*70*50 presegmented视频只需要30秒不到的时间(Pentinm 4,3.0 GHz,Matlab,挺快的);
3. 这种算法可以用于处理低精度的视频。

September 3, 2010

[Handii] 忙活了一个月,总算有个样子了

一个暑假半偷偷地在做这东西,最近又是老板又是作业的deadline,搞得我很崩溃。不过好在,差不多有个样子了。好不好用的再说,以后可以慢慢改~
起了个自己很得意的名字,叫“Handii”。Hand是因为用手交互,ii是为了像可爱的Wii同学致敬。听起来好像狗狗^^
实现了一些基本的手势交互,能做大概所有鼠标能做的事情,移动啊,点击啊,双击什么的。但是精度不高,也就是个能拿来玩玩的程度,还要多多努力啊。
还做了个3D俄罗斯方块,用Handii玩的,不过3D的俄罗斯方块真的好难。。。(我偷偷地设定了只要填30%的格就能消掉一行,不然死定)做得很赶,连计分板都没有。
因为想要做成一个随便什么人都可以拿来玩的东西,给用户最大的自由和最少的困扰,所以用了大家都买得到的网络摄像头,摄像头的位置也没有约束,考虑到成本也没用上双摄像头,也没有用特别的背景。通通这些都给后来的设计和实现带来了很大的挑战。摄像头的帧率不高,如果动得快就一片模糊;没有深度信息,做不了精确的定位;背景很复杂又常变化,摄像头好动不动突然自以为是地改变亮度,还有其他肤色部位(我的脸、我的手臂),所以不得已地用了指套。和SixSense的想法一样~,不过我最初设想的时候可不知道他们。如果可以的话,以后想要尽可能地把指套脱掉。
image[5]       image[2]
简易指套(做起来很简单的,彩条+双面胶)              姐姐我的手,还有京东上买的19米的摄像头
image[22] 7553D110 image[23] 
image[24] image[25] image[26]
一些能识别的手势:Catch / Release / Click / Double Clicke / Point
以后抽空偷偷接着做~ 持续更新撒~

July 5, 2010

完结!大年番~ 钢炼~!

周日时一集可有可无(还是有好10~20%)的大团圆各种福利后,钢炼TV Anime步漫画后尘地完结了。这一年里最大的追逐游戏结束了(另一场系福山大叔的龙马传)。

上一部Bones自由发挥的钢炼结局的意味深长,看完后数天总觉郁闷不止;所以果然还是Happy Ending来得舒心,各种和谐,各种福利~


# 炼金术师式新表白法!

00[10] 000[4] 
0000[2] 02[2]


# 各种和谐~

04[2] 05[2] 
06[2]
当皇帝咯~ 还是么眼睛。。(pia~)

07[2] 09[2] 
08[2]
大佐你最赚了,眼睛好了,还抱得美人归(小胡子。。成年的男人都这样吗。。)

10[2]
知道是谁吗?!!!!(好好捏)

11[2]
yoho~!结婚咯~ 生娃咯~ 成双成对咯~(你们了解的,谁和谁一对,不了解的去撞墙)

12[2]
高兴的辫子都不梳了,红衣服也不穿了


# 最后附上宅男大杀图一张

111[2]
温蒂你真是一语惊人啊~!