July 1, 2011

吐槽Android和宫崎大神

忙了一阵,写了个Android上的媒体程序杂烩,图片浏览、视频播放什么的,用作手势识别的控制Demo。Android或者说Java这个东西,果然是写C++的人三天就能上手的。不过,我还是很不喜欢Java不让主动释放对象这一设计,前段时间写Cuda让我对内存什么的变得相当敏感,定义个状态能bool一定不char,存个值能short一定不int。说到底,还是不信Java能管理任意程序的内存都管理得比开发者或者和开发者一样好。对于没有指针这件事情,也另人纠结,我喜欢星号啊。另外,吐槽一下Java里的boolean,为啥不用bool呢,明明是基于C++,为啥不延续,而偏偏让人多敲3个字符。。不满啊。不过,我很喜欢Java的接口设计。

至于Android,槽点太多,我都懒得吐了。充满差错的注释,混乱的函数命名,死板的工程结构,以及比摩托罗拉还慢的速度,我每天晚上吃饭前都要骂它几句,这货到底是不是Google生的啊。除了开源,除了便宜,除了能方便地用Google的服务,我想不到它有什么好处。如果让我挑平台,一定果断地投靠iOS,人家有一级流畅的UI,酷的基础气质,更重要的是有消费习惯良好的用户群体啊。以前我还抱怨过QT的UI,现在用过Android我就知道自己错了,QT相对Android在UI方面绝对是神级的存在。
有天吃饭时,边上一mm用一HTC手机切水果,黄香蕉出来的时候那叫一个卡啊,一帧一帧的,我这厢拿一iPhone眼看着水果一个个噌噌噌往下掉,羡慕嫉妒恨啊,原来在Android的机器上有没冰香蕉是一样的效果啊。

上个礼拜出了「借东西的小人」的DVD,所以国内的我终于可以看到宫崎大神的新片了。可惜小小失望了一把,除却音乐没发现什么眼前一亮的东西,故事本身只比「波妞」复杂了那么一点点。对“借”这一行为的阐述有些浅薄,为什么叫“借”不叫“偷”呢,借了是要还的,那小人的存在对人类而言“还”了什么呢。如果说回归自然才是小人族逃避灭族的出路的话,那相应地,是不是应该交代下小人族的历史?小人族和会说话的小老鼠的区别是什么呢,只是人形生物和野兽的区别么?另外,我一直很好奇,不想被人类发现的小人为啥会把窝建在一个这么好找到and好打开and便于被抓的地方。我一直期待的小人和小动物正面冲突也没有发生,小人和人类的正面冲突也没有发生。也许是2个小时总归短了点,使得这片世界观的塑造只到了床头故事的层次,就像某些寓言故事里某些动机不明的事件,只是存在着,没有前因后果。真的怀念「幽灵公主」和「风之谷」的厚重感。

May 12, 2011

[论文笔记] Real-Time Human Pose Recognition in Parts from Single Depth Images

Paper:J. Shotton, A. Fitzgibbon, M. Cook, T. Sharp, M. Finocchio, R. Moore, A. Kipman, and A. Blake. Real-Time Human Pose Recognition in Parts from a Single Depth Image. In CVPR 2011. http://research.microsoft.com/apps/pubs/default.aspx?id=145347


问题描述:文章提出了一种从单张深度图中提取3D骨架节点的方法。这种方法并不使用动作的时序信息,但是快速有效,识别帧率在200fps左右(GPU加速后),精度不逊于现有算法。这也是Kinect动作识别的核心算法。
文章最主要的贡献在于:将Pose estimation作为Object recognition看待,提出了一种新颖的识别方法——将Body part segmentation问题作为基于像素的分类问题来处理,这样就不需要对不同节点组合进行搜索,但同时单一部位很可能在局部剧烈地变化。算法的计算复杂度低,精度高。文章的实验部分还论证了以下观点:1)作为训练用的深度数据,合成数据可以很好地代替真实数据;2)获得高精度的重要一步是扩大并丰富训练数据;3)文章中提出的基于部位的识别方法比模糊的精确最近相邻节点更具有通用性。
2011-5-12 20-04-00

数据:
数据来源是几乎所有机器学习相关算法的头痛问题。对于动作识别,首先,出于对人物的着装、发型、材质等因素的多样性考虑,使用图形技术合成的训练图片在色彩和材质等方面均有很大的变数,使用深度图片虽然能避免一部分变数,但由着装和发型等带来的形状差异却无法规避;其次,驱动人物的动作数据本身均不可避免地来自Motion capture,这使得获取大量动作的工作量变得很大,虽然有一些技术致力于模拟人物动作,但至今尚不能解决人物主动运动的问题。
文章的真实深度图片来自于Kinect深度相机,由Primesense提供技术支持,是一种基于不可见近红外光的结构光深度恢复技术。这种深度摄像头可以在低光强度的环境下工作,提供一种标定尺度的深度估计,对色彩和纹理不敏感,可以天然地应对轮廓中的遮挡,最重要的是使得前背景分离问题变得简单,并且合成深度训练图也是相对直接简单的。文章的训练深度图片使用Mocap数据绑定多种不同的模型渲染生成。为了保证数据的多样性,在从大规模采集的数据中随机时,定义姿势之间的最小距离;对应人体部位识别的方法,训练数据的纹理也根据既定的分块着色,如下图所示。最终生成约100k frame训练数据。
2011-5-12 18-52-24

部位标识 / 部位识别 / 骨架生成:
部位标识的精度是可以根据需求自由定义的。文章中使用31个部分的部位标识:头4部分、脖子、2个肩膀等。
部位识别基于像素,即对每一个像素识别其所属部位。特征选择和识别算法引用了Lepetit等05年的工作(点我):特征选用简单的深度比较特征,识别算法使用多类随机决策树,树节点test为特征值是否大于某一阈值。训练过程微软采用了10million张图片,每张均匀随机2000个样本像素,训练了3棵20-depth的树,训练过程采用分布式实现,在1000核cluster上运行了约一天。(这个time consumption +_+)
骨架生成是基于像素部位分类和像素深度的聚类,使用加权高斯核的Mean-shift算法。这样得到的骨架节点在人体表面,之后需要有一个z值的向后偏移,才能得到正确的3D骨架节点。这个偏移值可以通过各个部位的分别学习获得。

效果:
简单的说,算法效率实时,效果不错。至少这是做了这么多年,第一次实时又有效的几乎万能动作识别算法。
像素级部位标识的精度在50-60%之间,整体骨架的精度大多部位在90%以上,wrist和hand的识别率较低,在80%以上。算法表现出样本越多,精度越高的现象(废话),且在大样本前提下over-fit的现象也能被避免。


这个文章的工作在本年会完全follow一次,末了再写个详细的算法评价。

May 10, 2011

[论文笔记] Randomized Trees for Real-Time Keypoint Recognition

Paper:V. Lepetit, P. Lagger, and P. Fua. Randomized Trees for Real-Time Keypoint Recognition. In Proceedings of the Conference on Computer Vision and Pattern Recognition, San Diego, CA, June 2005.


问题描述:文章是作者在前作基础上(04年ICCV)的完善之作,研究广泛意义上的特征点匹配问题,应用于相机定标、目标检测等各种领域。特征点匹配算法发展到现在,虽然对形状、视点、光照等变化及遮挡等逐渐变得鲁棒,但是没有算法引入过目标的三维信息和可能可以获得的训练图片等,匹配效果还有较大的提升空间。文章提出的算法引入了这些额外的信息,离线合成目标稳定特征点的各个视角,实时通过多类随机决策树将检测到的特征点分类(识别对应视角),最终使用RANSAC-method估计目标的3D姿态,达到匹配的目的。算法有效、实时、鲁棒。

训练数据的获取
对于立体目标,至少需要2张训练图片;对于平面目标,至少1张。对于目标的每一个特征点,生成其在各个视点下以其为中心的patch合集,如下图所示。假设目标是平面的,简单的仿射变换即可,定义缩放、选择、扭曲等参数,通过随机参数的方式生成样例;但对于立体的目标,至少需要2张不同视角的图片,用于重建目标的三维模型,再通过渲染技术生成样例(或者像google街景一样使用基于图像的渲染技术)。注:只适用于非凹体。所有的样本在训练之前还会进行高斯化、2D朝向估计与对齐的预处理,作为归一化的手段,使得分类更为容易。
2011-5-10 14-11-42

特征点的选择和识别
在众多样本及实时数据中,由于目标的扭曲、视点遮挡等原因,特征点并不一直保持统一。出于鲁棒性的考虑,需要选择其中最稳定的特征点,即在大多数视点下都能被检测到的特征点。另外,合成的样本图片被加入白噪声(接近真实的相机拍摄结果)和噪声背景,使得训练结果天然地对图像噪声鲁棒。
特征点的识别,文章中使用的多类随机决策树(或随机决策森林),相对于前作中的KNN算法更为高效,而且天然地适用于多类分类的问题。决策树节点的test使用简单的像素亮度对比。在实时识别中,图像的每个特征点patch的分类,由从每棵决策树获得的分类置信分布的平均值决定(取其最大者)。当置信值小于某一阈值时,认为该特征点不与任一目标特征点匹配。

结果
文章称,训练20棵10-depth的决策树森林,在普通PC上需要约15min,能够达到至少80%的识别率。实时的识别速度能够达到camera frame的速度,也就是约30fps。微软在kinect的核心算法中也借鉴了这篇文章的思路,并使用GPU加速识别过程,最后加上基于mean-shift的骨架生成,也是实时的速度,因此文章所称的实时效率是可信的。在效果上,文章对比了SIFT算法,称在高distort的情况下,SIFT只能检测到很少的匹配特征点,而此算法依旧;但在处理Scale情况时没有SIFT鲁棒,但这与算法框架本身无关,只是因为在选择特征点时没有使用多scale的特征。


文章的亮点在于其算法框架,即将特征点匹配问题转化为特征点的分类问题。其次,通过渲染技术生成特征点在各个视点下的Patch,也很有新意。是一种逆问题与正问题的结合思路。而且,此算法的效率也十分美。不过,相对于其他特征点匹配算法,需要训练,即是它的创新,也是它的弱点。毕竟,想要获得好的结果,一两张训练数据总是不太让人信任的;况且,需要训练的算法,其通用性往往受到制约,其易用性也自然比不上拈来即可用的算法。但不可否认,这是一个很有意思的算法。

April 20, 2011

[基础算法] Graph Cut and Its Application in Computer Vision

网络流算法最初用于解决流网络的优化问题,比如水管网络、通信传输和城市的车流等。Graph cut作为其中一类最常见的算法,用于求解流网络的最小割,即寻找一个总容量最小的边集合,去掉这个集合中的所有边将阻断这个网络。图像和视频也能被视作网络(或者MRF),以像素作为节点,具体应用定义相邻像素间边的能量值(容量)。因此从九十年代末开始,Graph cut渐渐被引入计算机视觉、图像处理和机器学习领域,用于优化分类、分割和合成等问题。

The Max-Flow and Min-Cost Problem:
定义图(或者流网络)G = (V, E),可以为有向图或无向图。图中所有的边 e(u, v) ∈ E 附有一个非负的容量 c(u, v) ≥ 0,即该边所能承受的最大流量。图中通常定义两个特殊的节点,源点 s 和终点 t;存在拥有多个端点的图,对其的Max-flow求解为NP问题,需要转化为双端点问题求解次优解。定义满足以下条件的 f : VXV → R 为图 G 上的流:
   ●  Capacity Constrain,对于所有 u, v ∈ V,f(u, v) ≤ c(u, v)
   ●  Skew Symmetry,对于所有 u, v ∈ V,f(u, v) = ﹣f(u, v)
   ●  Flow Conservation,对于所有 u ∈ V﹣{s, t} 和 v ∈ V,∑ f(u, v) = 0
从 s 出发的所有流量的总和就是整个图的总流量。如下图所示,图的当前总流量为19,没有达到最大值。
 
Cut(割)将整个图的所有节点分为两个不相交的集合 S 和 T,比如s ∈ S,t ∈ T。割的容量定义为:
     c(S, T) = ∑x∈S ∑y∈T c(x, y)。
Min-cut(最小割)就是图的所有割中容量最小的一个。算法上要直接找Min-cut是十分困难的,根据最大流最小割定理,即图的最大流量等于图的最小割容量,通常要将问题转化为与之等价的Max-flow问题(理论推导点我)。

Max-Flow and Min-Cost Algorithms:
Max-flow问题的求解有两类经典的算法,增广路径[1] 和Push-relabel [2]。增广路径类算法遵循循序渐进的原则,不断在图上查找从 s 到 t 的可用路径,从0开始慢慢地提升图的总流量至最大;而Push-relabel类算法则从局部出发,总是尽可能地向图中输送更多的流量,在不断重复的Push和Relabel操作中达到节点间的平衡,是水流的一种拟态。Push-relabel类算法具有较高的并行性,适用于GPU加速,大体流程点我。
增广路径类算法有很多衍生,但大多具有以下特性:1)维护残余容量网络;2)通过寻找Augmenting path逼近最大流。Augmenting path具有形式:s, e1, v1, e2, v2, … , ek, t,其中没有重复的节点、没有饱和的前向边和空流量的后向边。对残余网络的定义有很多形式,这里我们定义边的残余容量(Redsidual capacity,RC)当其为前向边时等于 c(i, j) – f(i, j),当其为后向边时等于 f(i, j),如下图所示。
 
Augmenting path的残余容量为其每条边残余容量的最小值,如上图路径的残余容量为1。Ford-Fulkerson算法不断在残余网络中查询Augmenting path,比如使用广度或深度优先搜索,直到再也找不到任何路径。例子点我。Boykov[3] 提出一种双向搜索并重用搜索树的增广路径算法,虽然理论复杂度较高,但在实际应用中却效率较高,因此很多需要Graph cut的应用都采用Boykov提供的源代码。

Applications in Computer Vision:
计算机视觉中很多问题,都可以归结为量化方程的优化问题。比如图像分割的问题,定义每一个像素属于前景或背景的可能性度量,那整个问题就变成了如何让整个可能性量化方程取值最大的问题。当然有时,我们还需要定义平滑项,用于约束相邻像素的属性变化。这就形成了在视觉中最为常见的一类能量优化方程:
      E(f) = Esmooth(f) + Edata(f)
1维图还可用动态规划方法求解,但2维以上由于其几何级的复杂度增长,则大多使用Graph cut。典型的应用有Segmentation、Stereo matching、Image Restoration、Motion estimation等。根据不同的应用有不同的图构、相邻约束和能量函数。Kolmogorov[4] 研究了什么样的能量方程能用Graph cut优化,并提出了三元及以下能量函数自动转换成图的方法。

Multi-label Graph Cut:
根据应用的需要,有时定义的图构是多个label的,也就是有多个灭点,如下图所示。这种图的Min-cut是Multi-way的,求解过程是一个NP问题(Boykov[3]在他的论文中有详细证明)。比如Stereo matching中的disparity、Image Restoration中的intensity等,其本质都是一个Multi-label的优化问题。虽然有些方法可以将其人为地转变为2-label,但这在很大程度上限制了能量函数的定义。
4-20-2011 5-01-57 PM
Boykov[3]提出了两种算法,能够在多项式时间内逼近Muli-label问题的最优解,并给出了详细证明和两种算法的optimality property讨论。这是一篇值得细读的文章。这两种方法都是在寻找Local minima,最终使得图中的任意一个像素改变其label都不能产生更好的解。在每一次迭代中,两种方法分别进行 α-expansion 和 α-β-swap 形式的move 优化。α-expansion move 是指扩展 α-label 区域,使原本其他 label 的点属于 α;α-β-swap move 则只针对 α-label 和 β-label 区域,使其中的一些点的label从 α 变为 β 或相反。每一部迭代都是一次2-label的优化过程,形成以 α 和 非α 为灭点、以及以 α 和 β 为灭点的图,寻找最优cut,重整label,不断逼近最优解。α-expansion 要求平滑项满足三边定理,而 α-β-swap 可用于任意平滑项定义;但 α-expansion 有严格的optimality property bound,总不会产生太坏的结果,因此被较多地使用。

Dynamic Graph Cut:
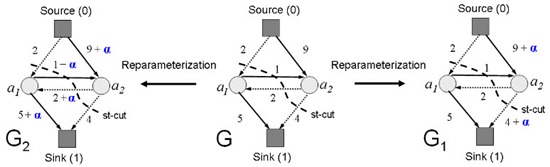
动态图指一个图序列,在时序上前后图直接会保持平滑的过渡,因此,是否可以在前一张图的residual graph基础上修改变化了的像素点的能量以快速地求解?Dynamic graph cut并不寻求最优解,而是次优的快速的解。Kohli[12] 使用重新参数化图(Graph Reparameterization)的方法修改动态变化的数值,并保持Capacity、Flow等基本约束,而后直接得到次优解。这种方法可以容忍少量边的修改和少量任意节点拓扑的重构,但是和其他所有Dynamic graph cut算法一样,以少量、也就是轻微的时序变化为前提。主要应用于视频相关的视觉方法,如Video segmentation。
4-20-2011 5-14-35 PM 


Bibliography:
[1] L. Ford , D. Fulkerson. Flows in Networks. Princeton University Press, 1962.
[2] Andrew V. Goldberg, Robert E. Tarjan. A new approach to the maximum-flow problem. In Journal of the Association for Computing Machinery, 35(4):921–940, October 1988.
[3] Y. Boykov, V. Kolmogorov. An Experimental Comparison of Min-Cut/Max-Flow Algorithms for Energy Minimization in Vision. In IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI), volume 26, page 1124-1137, 2004.
[4] V. Kolmogorov, R. Zabih. What Energy Functions Can Be Minimized via Graph Cuts? In IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI), volume 26, no.2, page 147-159, 2004.
[5] V. Kolmogorov, R. Zabih. Multi-camera Scene Reconstruction via Graph Cuts. In European Conference on Computer Vision (ECCV), May 2002 (best paper).
[6] Y. Boykov, O. Veksler and R. Zabih. Faster approximate energy minimization via graph cuts. In IEEE Transactions on Pattern Analysis and Machine Intelligence (PAMI), volume 23, no. 11, page 1-18, 2001.
[7] S. Roy, I. Cox. A maximum-flow formulation of the n-camera stereo correspondence problem. In International Conference on Computer Vision (ICCV), 1998.
[8] V. Vineet, P. J. Narayanan. CUDA Cuts: Fast Graph Cuts on the GPU. In: CVPR Workshop on Visual Computer Vision on GPUs, 2008.
[9] V. Kwatra, A. Schodl, I. Essa, G. Turk and A. Bobick. Graphcut Textures: Image and Video Synthesis Using Graph Cuts. In SIGGRAPH 2003, pp. 277-286.
[10] A. Blum, J. Lafferty, M.R. Rwebangira and R. Reddy. Semi-Supervised Learning Using Randomized Mincuts. In Proceedings of the 21st International Conference on Machine Learning (ICML), Banff, Canada 2004.
[11] S. Z. Li, Markov Random Field Modeling in Computer Vision, Springer Verlag, 1995.
[12] P. Kohli and P. H. S. Torr. Dynamic graph cuts for efficient inference in markov random fields. IEEE Trans. Pattern Anal. Mach. Intell. (PAMI), 29(12):2079–2088, 2007.

March 7, 2011

[基础算法] 一个Ford-Fulkerson算法的例子

Example:
3-7-2011 10-07-02 AM 

Initialized:
2

Augmenting path:s→a→b→t,excess capacity:min(4, 3, 5) = 3
f(G) = 3:
3

Augmenting path:s→a→t,excess capacity:min(1, 5) = 1
f(G) = 4:
4

Augmenting path:s→c→d→t,excess capacity:min(6, 4, 4) = 4
f(G) = 8:
5 

Final result:
6

March 3, 2011

[论文笔记] CUDA Cuts: Fast Graph Cuts on the GPU

Paper:V. Vineet, P. J. Narayanan. CUDA cuts: Fast graph cuts on the GPU. In Proc. CVPR Workshop, 2008.


问题概述:Graph cut是一种十分有用和流行的能量优化算法,在计算机视觉领域普遍应用于前背景分割(Image segmentation)、立体视觉(stereo vision)、抠图(Image matting)等。但在获得不错效果的同时,Max-flow / Min-cost问题求解的时间代价却很大。本文作者称其所知最佳的Graph cut实现求解一张640×480的图至少需100毫秒(平均数据会差得多),无法满足实时应用的需求。但事实上,Max-flow求解中经典的Push-relabel算法在流的计算和维护上只与局部相关,具有潜在的可并行性,适于GPU加速。因此,作者实现了push-relabel算法的GPU版。作者称其算法于一张640×480的图平均每秒可以求解150次Graph cut(Nvidia 8800 GTX),也就是约6.7毫秒速,是传统CPU算法约30-40倍速。作者还提供源码的下载,点我。

Definition & Notation:
对于一个图 G = (V, E) ,其中 V 为节点集合,包括源点 s 和终点 t (也可以定义多个端点,其可以优化为双顶点图)、以及其他诸多中间节点集合 V’ ,E 为连接这些节点的边,每条边附有容量 c(u, v) 代表节点 u 通过这条边流向节点 v 所能承受的最大流量,在具体应用中边的容量通常等价于其能量值。Graph cut的目的在于找到图的Min-cut,Cut将 V’ 分割为两个部分,去掉这些边将使舍得图中的任意一个节点只与 s 或 t 相连通(如下图),而Min-cut是所有cut中边的能量值总和最小的一个。
3-2-2011 2-56-05 PM
算法上要直接找Min-cut是十分困难的,通常要将问题转化为与之等价的Max-flow问题(理论推导点我)。Graph cut具体应用的性能关键在于能量函数的定义,用于计算机视觉中的一种常见能量函数定义如下:
3-2-2011 2-54-11 PM
Dp 定义数据能量,Vp, q 定义平滑度能量,N 定义相邻关系,fp 为像素 p 的标签(属于 s 或 t )。
 

经典Push-relabel算法:
求解Max-flow有两种经典的算法:Ford-Fulkerson和Push-relabel算法。Ford-Fulkerson算法的大意是在图中不断寻找 s 和 t 之间可用路径,记入总流量,并维护一张残余网络(Residual graph),直到再也找不到可用路径为止,此时的总流量就是Max-flow(具体算法点我)。Ford-Fulkerson算法的串行性很大,因为可用路径的查找是全局性的,这是GPU所不擅长的。
 
Push-relabel算法,相对的,具有很强的局部性和可并行性,在每一个子操作中指关心节点及其相邻节点。Push-relabel的基本思路是将尽可能多的流量从 s 推向 t ,但是当 t 已经无法再接受更多的流量时,这些流量将会被反推回 s,最终达到平衡(和Ford-Fulkerson算法一样,再也找不到 s 到 t 的可用路径)。算法过程中的“流”称为Preflow(先流),它并不像Ford-Fulkerson算法过程中的流一样总是持续升高直至Max-flow,而是初始预测一个值,在不断趋近于Max-flow,过程中可能出现回流的现象。Preflow对每一个节点满足 e(u) = in(u) – out(u),且 e(u) ≥ 0。当 e(u) > 0 时,节点 u 溢出(overflowing)。溢出的节点需要将多余的流量Push向其相邻的节点,即Push操作。当一条从 s 到 t 的路径上所有的节点都不溢出时,此路径上的Preflow就变成真正的Flow了。
 
Push-relabel算法和Ford-Fulkerson算法一样都会维护一张残余网络。对于图中的每一个节点 u,若在残余网络中存在 e(u, v),则 h(u) ≤ h(v) + 1。Push操作只能在 h(u) > h(v) ,u 节点溢出且 e(u, v) 残留容量时进行;而当 u 节点溢出,且与之相邻所有残留边节点的 h(v) ≥ h(u) 时,只能进行Label操作,增加节点 u 的高度,即 h(u) += 1。在初始化时,h(s) = n,t 及其他所有节点的高度均为 0;从 s 出发的所有边初始化 f(e) = c(e),其余边 f(e) =0。Push-relabel算法将不断重复Push和Label操作,直至任意操作都无法进行。
(更详细的算法步骤推荐查阅Tutorial,点我)
 
比较形象点,Push-relabel是泛滥的洪水,奔腾向前,堵了就倒流;Ford-Fulkerson则是很温吞的做法,先找个人探路,回来报告能流多少水就开闸放多少。
 

Push-relabel算法的GPU版:
存储和线程结构:
Grid拥有和输入图片一样的维度,并被分为若干个Block,每个Block的维度为 B×B。每个线程对应一个节点(像素),即每个Block对应 B×B 个节点、需要访问 (B+2)×(B+2) 个节点的数据。每个节点包含以下数据:溢出量 e(u),高度 h(u),活跃状态 flag(u) 以及与其相邻节点间的边的容量。活跃状态共3种:Active,e(u) > 0 且 h(u) = h(v) + 1;Passive,e(u) > 0 且 h(u) ≠ h(v) + 1,这种状态在Relabel后可能变成Active;Inactive,没有溢出且没有相邻残留边,
这些数据存储在全局或设备内存中,被所有线程共享。
(GPU架构及Cuda指南参考NVidia相关手册,点我)
 
本文作者通过4个Kernel实现GPU版Push-relabel算法:
1) Push Kernel (node u):

   ■ 将 h(u) 和 e(u) 从全局内存读入到Block共享内存中(使用共享内存是因为一些数据会被相邻线程共享,这种读入方式相对单独的读入更节省时间);
   ■ 同步线程(使用共享内存都需要做这一步,为了保证所有内存都被完全读入了);
   ■ 将 e(u) 按照Push规则推向相邻节点(不大于边的剩余容量,且 h(u) ≥ h(v) );
   ■ 将以上Preflow记入一个特殊的全局数组 F。
之所以记入 F,而不直接写入相邻节点,是因为在并行Push操作时,一个节点的溢出值同时受到多个相邻节点的影响,如果直接写入,可能造成数据的不一致性(Read-after-write data consistency)。因此,作者将原来的Push操作分成了Push和Pull两个Kernel执行(另一种选择是在同一个Kernel中分两部分执行,之间进行一次同步,但是对于Block边缘的节点,这种同步需要等待其他Block的线程,这种Block间的同步并不被所有GPU支持)。
 
2) Pull Kernel (node u):
   ■ 读入 F 中推向 u 的Preflow;
   ■ 累加所有新的Preflow,得到最终的溢出值,记入 e(u) 到全局内存。
  
3) Local Relabel Kernal (node u):
按照经典Push-relabel算法中的Relabel操作,局部地调整节点的高度
   ■ 将 h(u) 和 flag(u) 从全局内存读入到Block共享内存中;
   ■ 同步线程;
   ■ 计算 u 相邻 active / passive 节点的最小高度;
   ■ 该最小高度+1,作为新高度写入 h(u) 到全局内存。
  
4) Global Relabel Kernal:
从终点 t 开始,按照广度优先策略,遍历所有节点,更新其高度至正确的距离(节点的高度总是其与终点距离的下限)。迭代次数 k 被记录与全局内存中。
   ■ 如果 k == 1,所有与 t 相邻且有残留边的节点高度被设为 1;
   ■ 所有未被设置的节点检查其相邻节点,若其相邻节点的高度为 k,则设置该节点高度为 k+1;
   ■ 更新高度值到全局内存。
  
算法总体流程:
a. 计算能量矩阵 → b. Push+Pull Kernel循环 → c. Local Relabel Kernel循环 → d. Global Relabel Kernel循环 → e. 重复b到d至收敛(没有可进行的Push和Relabel操作)


作者还基于GPU实现了Dynamic graph cut,应用于连续细微变化的Graph cut,通过对前一帧的简单修改形成新图,重用其他数据,加速Max-flow的求解。作者的实验数据称GPU实现可以提速70-100倍。不过具体应用具体分析,提速肯定是有的,多少未知,要待我实现过试验过。据说这个印度人提供的代码Bug颇多,虽然不太信,但还是先做了要重新实现的准备。末了,吐个槽,这论文贡献不大,确实只是发Workshop的水平。

December 28, 2010

2010年终盘点

前些日子杭州下了05年来最大的一场雪,青天白日的乱飞积了一地,想起当年姐还小的时候在ZJG堆的龙猫雪人和红晕龙猫雪人,时间过得真快。然后,今年有件可喜的事是收获了一颗大饼,皮糙肉厚耐摔耐磨。

※音乐
说起来今年真没听什么歌,偶尔开起播放器也是听些老掉牙的协奏曲或者前些年攒下的歌。L团也不活动,就很少关心各种新曲的消息,兴致淡了。看了下文件夹的修改时间,几乎没有下半年的。年初VeryCD上down的几十张企鹅三星唱片,一遍都未过完,也不知该说是太忙还是太懒了。
陈奕迅今年发的些碟们倒是都听过几遍,「沙龙」和「於心有愧」听着喜欢,还装模作样地K过一回,只是粤语什么的说得太对不起了。
刨到些 いきものがかり 的老专辑,羡慕主唱有力的声音,什么唱起来都觉得励志,「SAKURA」最高。今年新发的单曲,「ありがとう」很温情,「時をかける少女」是某穿越真人片的主题歌,最不喜这种二次元真人版,但歌很是 いきものがかり 的风格。
YUI 今年也好些作品,「to Mother」老实惊艳了一下,第一次见她弹钢琴,比摆弄吉他时果然温柔淑女多了。
断断续续地下完了 吉田拓郎 的一张4CD精选,85年出,也就是他隐退的前夕。最初是去找「夏休み」,反反复复就几句词,曲风应该是民谣吧,耐听的。
追钢炼识了个新乐队 シド ,主唱是个非主流,所幸声音还行,听CD比现场舒服些。
暑假时在图书馆借了 帕格尼尼 的传记,还找了摩西幻想曲来听,这曲子对演奏者技巧的要求很高,是首很厚重的咏叹调。

※动画
今年的动画倒是每季都挑了喜欢的追。剧场什么的国内能看到的也都下着看了。整理了下才发现如果没有VeryCD没有BT我会死掉的,对国外的资源实在太依赖了。
# 残留的钢炼完结了
年番,从去年一直播到今年中。照着漫画的剧情,最后一场架结结实实地打了10集,剧情上果然比上作严谨得多。连带着还有很多好听的OP/ED,丰富了在下的精神文化生活。
# 无头骑士异闻录 | デュラララ!!
「BACANO! 」原班制作人马,一样奔放地剪TV动画像剪电影,不输骨头的流畅动作,我喜欢的非恐怖灵异故事。十分喜欢动画里主角们的聊天系统,不知是仿的哪个软件,恰到好处的排版和头像设计,爱!据说会出续作,想想也会,头都没拿回来,还有故事好讲,「BACANO! 」也是两季的故事。我想看静雄打架!!!
# 交响情人梦Finale | のだめカンタービレ フィナーレ
例行追的。轻松搞笑好看。野田妹什么的最萌了。千秋什么的最好推倒了。我邪恶了。
# 机动战士高达UC | 機動戦士ガンダムUC
独角兽。白白的机体,我觉得不太好看的说。复古的人设,应该是要向老祖致敬什么的。大饼要看的,我就跟着看了。剧情俗套,和几年前看柯南剧场没什么差别,但这是一种感情,高达饭的话应该是这样的。我这样的就是来看打架的。
# 轻音少女 第2季 |  けいおん!!
觉得没有第一作好看的说,歌的话需要吐槽一下某OP,难听死了,小日本的口味真奇特,「No Thank you!」什么的好听多了,只混个ED。轻音今年还是Oricon大丰收,这种音乐题材的动画真是有的赚啊。
# 大神与七位伙伴 | オオカミさんと七人の仲間たち
这旁白的声音真是听过一次能记住一辈子,太有特点了。该作的特点是胆小的用弹弓的男主角、傲娇系用猫猫拳套的女主角和腹黑的私生子女二号。其实也普通的说,我就是喜欢人设的画风和旁白的声音= =
# 传说中勇者的传说 | 伝説の勇者の伝説
我以为这片全年龄向的,只是这制作组总是有意无意地腐一下,尤其是最后几集,又是小清新又是暧昧的,受不了。女主角是个我喜欢的类型,拿大剑崇拜团子神的好女人。男主角们不评论,腐者自腐。
# 南家三姐妹 | みつどもえ && 妄想学生会 | 生徒会役員共
这两个放一起,因为都是重口味的四格改编题材。女生KUSO起来真不是盖的啊。我就喜欢看欢乐的片子。顺便同情下两部片子里负责吐槽的男主角们,工作太辛苦了。
# 学园默示录 | 学園黙示録 HIGHSCHOOL OF THE DEAD
这片该是男性向的,又是大胸又是打僵尸的。虽然打架真的蛮好看的,我还是要担心下这片坑挖得太大填不上烂掉。全世界都变僵尸了这种话题,好在日本没有广电某局,不然估计编剧抓破脑袋也写不出一个有利青少年成长的结局。
# 滑头鬼之孙 | ぬらりひょんの孫
我对这片最不满的是这废柴女主角,我要奴良和雪女在一起!重复一千次。
# 只有神知道的世界 | 神のみぞ知るセカイ
这故事很有趣。男主是个玩GALGame玩得出神入化对三次元完全没有兴趣的宅男,号称攻略之神,so某穿粉红色披肩的魔鬼小妞就找上他了。平均3集攻克一个不同类型的三次元女,驱除捕获她们心灵缝隙里的驱魔,用的还是游戏里的攻略思维。真宅男们看着应该更有趣点,我就是去围观PFP的。
# PANTY and STOCKING | パンティ&ストッキングwithガーターベルト
神作!必须膜拜。乍一看还以为是飞天小女警。GAINAX果然搞怪,就是要吓你一大跳。大尺度啊大尺度。
# 食梦者 | バクマン。
据说是原作者自身经历的改编,描写的是少年漫画家的成长,热血的说。还有“实现梦想前不交往,实现了以后我们结婚”这样的纯爱。青春什么的真是美好啊。
# STAR DRIVER 闪亮的塔科特 | STAR DRIVER 輝きのタクト
好了,BONEZ,我要来吐槽你。你说你出个啥低龄的「Hero Man」我就原谅你了,你还(<ゝω・)綺羅星!★(注意这是个动作!),你还“银河美少年”,你还“飒爽登场”,你想干啥?!我看这片我每回都羞耻感大增,我容易么我,就为着听鱼mm唱歌,为着乃是BONEZ。现在我每回看,都觉得这是个喜剧片,BONEZ乃绝对是故意的。
# 少女妖怪石榴 | おとめ妖怪ざくろ
我很喜欢她们打架时唱的歌,快出OST吧要拿来当铃声。
# 侵略!乌贼娘 | 侵略!イカ娘
巨萌的乌贼娘,不解释!
# 猫屎一号 | Cat shit One
难得日本人能拍出这么好的3D动画,兔子的短腿真是太萌了,还要装正经说“危险”。。快出第二集吧。每个国家的人都用一种动物代替,打起架来还是蛮新颖的,只是我不明白法国人为啥是猪呢。。

※电影
这个有些多,新的旧的还有些清掉了,全的列表是拿不到,挑几个印象深刻的说说。(有些心心念念想看的片子还木有出DVD,国内又不引进的,借东西的小人、长发公主什么的,只有等明年了)
# 驯龙高手 | How To Train Your Dragon
傲娇系小萌龙和技术宅男主角都赞的。几个配角小龙也蛮有趣的。梦工厂这次的龙设很讨巧,线条有些拙,化掉了龙们的戾气,最终BOSS都觉得多凶的说。故事讲得也张弛有度,笑点什么的那是梦工厂的片子里从来不缺的。特别赞一下几个男主角和小萌龙单独相处时对小萌龙表情的控制。另外,小萌龙长得有点像MH里的迅妹,就是尾巴上不长刺。(我坚信这片子会出2)
# 卑鄙的我 | Despicable Me
这是本光明正大地宣称做全世界最大的大盗是天底下最了不起的事情的片子。第一遍看的时候,发现金字塔被偷走的开头很有冲击力。全片最出彩的是那些个明黄色的胶囊小人,很佩服主角可以记住他们每个的名字,DVD里附的3个短篇很好看。
# Mai Mai Miracle | マイマイ新子と千年の魔法
09年的片子。日本乡村风格。片子所谓的魔法只是一个毛头小妞凭空的想象力,因为生活平凡,就在乡间小路上狂奔时想象有个精灵和自己赛跑,想象千年前这土地上曾存在过的繁华的都城,以及都城里一位从京城来还没有朋友的公主。巧的是,来了个东京的转学生,穿和乡下人不一样的粉红洋裙,用24个颜色的彩铅,做客时的礼物是没见过的酒心巧克力(小时候我也吃过这个,好怀念啊)。然后是理所当然地被排斥,理所当然地偏偏和主角交好,理所当然地高潮,理所当然地现实与想象的冲突。好在这种温情的片子总会有个愉快的结尾。魔法什么的,是存在于每个人的心里的。
# 成为约翰·马尔科维奇 | Being John Malkovich
99年的老片。有点恐怖的说。男主角曾是个木偶艺人,偶尔在打工的七楼半公司档案室发现了一个小门,从那个小门可以通向一个名叫马尔科维奇的明星脑内,见其所见感其所感的无比真实的15分钟体验。于是男主角伙同某艳女做起了一门“Being John Malkovich”的生意,并渐渐学会了控制马科尔维奇,就像当初控制木偶一样。他呆在马科尔维奇脑内的时间越来越长,终于抛弃自己的肉体做起了马科尔维奇。结局是出乎意料的犀利,马科尔维奇和那个神秘的通道最初就是作为一群老头老太获得永生的工具而存在的,而主角被诱骗出马科尔维奇的身体,又误闯进其孩子的脑内,最后被幼儿强烈的潜意识吞没。这种永生方式新鲜的说,只是换做你,愿意作为自己死去,还是作为他人永生呢?
# 人类之子 | Children Of Men
这片说的是很久很久以后人类几乎失去了生育能力,这时一个在英国的非法移民非洲女孩成为了最后一个孕妇,被男主角保护着去找某传说中的友善组织。其实第一个逗号结束就是本片剧情的全部亮点了,导演真是会想。还有个亮点是片末一个好长好长的长镜头,豆瓣上这片的评论几乎赞的都是这个。技术的确蛮赞的。最后男主角死得也蛮好的,只可惜那个孩子木有死,不然这片子在豆瓣上就有9分了。不过,我的话,还是觉得谁都别死一起喝庆功酒比较好。
# 傲慢与偏见 | Pride And Prejudice
这片以前就老见猫看,今年我总算把它看了,还买了本原著,王科一版的。看了一遍,暂时还只能理会到爱情那一层,人性啥的没怎么看出来。私以为小说什么的,还是单纯些把故事写好人物写真就够了,什么中心思想什么段落主题都是后人瞎YY的GP,人家作者就是活得腻了YY了个“假如我的人生是这样”或者实现活得不得志发发牢骚。最讨厌某颜色学家。最后,这片好看的。
# 歪小子斯科特对抗全世界 | Scott Pilgrim vs. the World && 海扁王 | Kick-Ass
这两个片子放一起,因为都是打片。爽!爽!爽!前一个宅些,充满了电子游戏的影子。后一个的亮点是大力小萝莉,and我觉得会出续集。

# 深夜食堂
这不是电影,我顺便。09年番。是个充满了人情味的日剧。摘一段每段片头深夜食堂老板的话:
       一天结束了 在大家都各自赶回家的时候 我的一天才刚刚开始
       菜单只有这些(豚汁定食、酒什么的4样) 其他的只要是你喜欢的我能做的就可以点 这就是我的经营方法
       营业时间是从晚上12点到次日早上7点
       大家都把它叫做深夜食堂
       你问这样还有没有客人会来? 客人还挺多的
片子的大致故事就这样了,25分钟一集,都是些平凡的小故事,各式各样的人在深夜食堂的小房间里谈论着。很喜欢这种气质的片子。
OP也赞,推荐下。铃木常吉「思ひ出」。

※新置物品
一台本子、一颗大饼。

OVER。